找到 745 篇与 csd 相关的结果 - 第 12 页
-
 爱客影视CMS米酷优化版 源码介绍 爱客影视CMS管理系统米酷优化版,修复了采集功能、尝鲜可自动采集尝鲜、手动尝鲜采集、也可单独采集和上传。 源码截图 1.jpg 2.jpg 3.jpg 更新内容 后台采用layuicms框架 增加QQ登录模块 增加全站缓存和伪静态功能 增加打赏功能模块 增加支付模块 增加淘宝客和京东客联盟 修复播放页弹窗问题 修复尝鲜列表和自动尝鲜分页问题 ⬇️ 下载地址 {cloud type="weiyun" title="腾讯微云" url="https://share.weiyun.com/Fqr4Nkta"} {cloud type="tianyi" title="天翼云盘" url="https://cloud.189.cn/t/MrIfqiNfe6Nb"} {cloud type="default" title="网盘下载" url="https://www.yun.cn/s/8b2112db3d214537a3ac6bedee05d6d7"} 下载后请先检查文件完整性,如有问题请在评论区反馈

-
roncoo-education {card-default label="? 项目信息"} ? 项目名称:roncoo-education ? 开发语言:Java ⭐ Star数:5599 | ? Fork数:2549 ? 开源协议:AGPL-3.0 ? 项目地址:https://gitee.com/roncoocom/roncoo-education {/card-default} 项目介绍 领课教育系统是一套基于点播、直播、考试、题库、任务等功能完善的在线教育系统,开源版是基于商业版精简实现的一个网课网校系统,致力于打造一个各行业都适用的在线培训系统、远程教学平台、学习管理系统、知识付费系统。 项目详情 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 使用须知 可以用于个人学习、毕业设计、教学案例、公益事业等。 商用限制,若要商用请咨询:18302045627(微信可加)。 禁止将本项目的相关代码和相关资料进行任何形式任何名义的出售。 项目介绍 领课教育系统(roncoo-education)是基于领课网络多年的在线教育平台开发和运营经验打造出来的产品,致力于打造一个各行业都适用的分布式在线教育系统。系统采用前后端分离模式,前台采用vue.js为核心框架,后台采用Spring Cloud为核心框架。系统目前主要功能有课程点播功能,支持多家视频云的接入,课程附件管理功能,支持多家存储云的接入,可以帮助个人或者企业快速搭建一个轻量级的在线教育平台。 目前集成AI写作能力,采用流式输出技术,实时生成课程简介、教学大纲等专业教育内容,显著提升课程内容生产效率和质量,我们会陆续添加更多AI能力,请持续关注。 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 演示地址 门户系统:https://eduos.roncoos.com/ 管理系统:https://eduos.roncoos.com/admin/ 前端技术体系:Vue3 + Nuxt3 + Vite8 + Vue-Router + Element-Plus + Pinia + Axios 后端技术体系:Spring Cloud Alibaba2025 + MySQL8 + Nacos + Seata + Mybatis + Druid 源码地址 后端系统:roncoo-education(核心框架:Spring Cloud Alibaba):码云 | Github | Gitcode 门户系统:roncoo-education-web(核心框架:Nuxt3):码云 | Github | Gitcode 管理系统:roncoo-education-admin(核心框架:Vue3):码云 | Github | Gitcode 关注微信公众号可获取更多学习资料(SQL脚本、部署教程、常见问题等) 项目截图 ⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/roncoocom/roncoo-education/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
mendmix-cloud {card-default label="? 项目信息"} ? 项目名称:mendmix-cloud ? 开发语言:Java ⭐ Star数:2732 | ? Fork数:1157 ? 开源协议:Apache-2.0 ? 项目地址:https://gitee.com/dromara/mendmix-cloud {/card-default} 项目介绍 Mendmix-cloud定位是一站式云原生架构技术底座。Mendmix-cloud提供了数据库、缓存、消息中间件、分布式定时任务、安全框架、网关以及主流产商云服务快速集成能力。基于Mendmix-cloud可以不用关注技术细节快速搭建高并发高可用基于微服务的分布式架构。 项目详情 项目截图 资源索引 快速开始 文档列表 快速上手-mendmix-tutorial 集成项目-oneplatform 简介 Mendmix定位是一站式分布式开发架构开源解决方案及云原生架构技术底座。Mendmix提供了数据库、缓存、消息中间件、分布式定时任务、安全框架、网关以及主流产商云服务快速集成能力。基于Mendmix可以不用关注技术细节快速搭建高并发高可用基于微服务的分布式架构。 发展历程jeesuite-libs→Mendmix 2015年发布第一版取名叫jeesuite-libs一直沿用至今,定位是工具型软件,以各个模块能完全独立使用为前提。经过近8年的发展以及在多家大型公司技术中台、数字化转型、企业上云过程中锤炼,定制化越来越高,jeesuite-libs从原来一个个离散的点变成了一个逻辑完备的面,也就是形成了一整套分布式架构及云原生架构的解决方案。基于这种转变jeesuite-libs不再适合我们的发展方向,因此现在更名为Mendmix。 关于Mendmix ✅寓意:Mend+Mix,解决各种框架整合、各种场景的融合的问题、形成一整套完全自洽的解决方案 ✅理念:融合、增强、包容、自洽 ✅原则:最小依赖可运行;只做增强不修改依赖框架本;贴近业务场景只做有用的功能 最小运行依赖 以下是包含了消息队列、定时任务、存储、全局锁、缓存、Mybatis增强等各种场景最小化运行依赖。如果需要支持分布式仅仅只需要增加必要的配置和第三方依赖包即可。 Spring + Springcloud必要组件 Mybatis,mybatis-spring,Druid Quartz 以及一些诸如guava,jackson的工具类库 功能图谱 模块核心功能说明其他说明mendmix-commonhttp、json、加解密、异步、GUID等工具类以及整体架构一些规范性定义 mendmix-common2分布式锁、轻量级定时任务、全局workerId生成等依赖中间件的通用组件 mendmix-springSpring工厂以及一些相关工具类、配置二次处理、一些运行机制规范定义 mendmix-cache缓存中间件适配、多redis实例快速注册及管理 mendmix-scheduler分布式定时任务,基于quartz、redis、zookeeper实现,支持日志上报、重试、多租户、并行处理,提供管理API支持redis或zookeeper分布式协调mendmix-mybatisCRUD增强、通用字段自动处理、自动缓存、读写分离、软删除、乐观锁、数据权限、安全审计兼容Mapper3增强框架mendmix-security认证和鉴权(接口权限)、session管理器、支持oauth2.0等不依赖任何第三方权限框架mendmix-logging多日志厂商适配、日志采集上报、应用日志动态刷新机制 mendmix-springweb接口规范定义,通用拦截器、mock用户、请求响应增强插件机制 mendmix-springcloud-support组件自动注册、springcloud 组件增强 mendmix-gateway认证、接口权限、审计日志、openAPI、响应统一包装、限流、防重复提交、命中缓存降级访问默认集成mendmix-security模块mendmix-amqp-adapter消息中间件适配,目前支持:内存队列、redis、kafka、rocketMQ、腾讯云及阿里云的云厂商MQ产品 mendmix-cos-adapter文件存储适配,目前支持:minIO、七牛、阿里云、腾讯云、华为云、AWS的文件存储服务 版本 sonatype https://search.maven.org/search?q=mendmix 关于作者 15年IT互联网老兵,熟悉微服务、k8s、云原生架构及各种分布式架构; DDD领域驱动早期实践者,2012-2014年作为开源项目koala企业级开发平台核心开发主推领域驱动设计理念; 荣获2021年度海纳奖—分布式数据库十大优秀实践人物 项目截图 ??知识星球?? 欢迎加入我的知识星球。提供mendmix各种问题交流,定期分享架构实践、架构案例、面试技巧等。项目截图 ⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/dromara/mendmix-cloud/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
fire {card-default label="? 项目信息"} ? 项目名称:fire ? 开发语言:Scala ⭐ Star数:727 | ? Fork数:231 ? 开源协议:Apache-2.0 ? 项目地址:https://gitee.com/fire-framework/fire {/card-default} 项目介绍 Fire框架是中通大数据自主研发并开源的大数据框架,专为Spark和Flink任务开发设计,可显著降低70%以上的代码量。该框架创新性地采用基于注解的方式进行Spark和Flink任务开发,并集成了实时血缘追踪、根因诊断、动态调优以及参数热调整等多项平台化功能。Fire框架已被数十家公司采用,累计收获了近千个Star,并拥有超过200人的社区,其中包括来自美团、阿里巴巴、作业帮等知名企业的成员。 项目详情 项目截图 项目截图 项目截图 Fire框架 Fire框架是由中通大数据自主研发并开源的、专门用于进行Spark和Flink任务开发的大数据框架,可节约70%以上的代码量。首创基于注解进行Spark和Flink任务开发,具备实时血缘、根因诊断、动态调优、参数热调整等众多平台化功能。Fire框架在中通内部每天处理数据量高达数千亿,在外部已被数十家公司所使用。 一、就这么简单! 1.1 Flink开发示例 @Config( """ |state.checkpoints.num-retained=30 # 支持任意Flink调优参数、Fire框架参数、用户自定义参数等 |state.checkpoints.dir=hdfs:///user/flink/checkpoint |""") @Hive("thrift://localhost:9083") // 配置连接到指定的hive @Streaming(interval = 100, unaligned = true) // 100s做一次checkpoint,开启非对齐checkpoint @Kafka(brokers = "localhost:9092", topics = "fire", groupId = "fire") object FlinkDemo extends FlinkStreaming { @Process def kafkaSource: Unit = { val dstream = this.fire.createKafkaDirectStream() // 使用api的方式消费kafka sql("""create table statement ...""") sql("""insert into statement ...""") } }1.2 Spark开发示例 @Config( """ |spark.shuffle.compress=true # 支持任意Spark调优参数、Fire框架参数、用户自定义参数等 |spark.ui.enabled=true |""") @Hive("thrift://localhost:9083") // 配置连接到指定的hive @Streaming(interval = 100, maxRatePerPartition = 100) // 100s一个Streaming batch,并限制消费速率 @Kafka(brokers = "localhost:9092", topics = "fire", groupId = "fire") object SparkDemo extends SparkStreaming { @Process def kafkaSource: Unit = { val dstream = this.fire.createKafkaDirectStream() // 使用api的方式消费kafka sql("""select * from xxx""").show() } }说明:structured streaming、spark core、flink sql、flink批任务均支持,代码结构与上述示例一致。 二、开发与示例 2.1 Spark开发示例 2.2 Flink开发示例 示例项目clone后导入idea即可run,无需任何额外配置! 三、亮点多多! 3.1 兼容主流版本 fire框架适配了不同的spark与flink版本,支持spark2.x及以上所有版本,flink1.10及以上所有版本,支持基于scala2.11或scala2.12进行编译。 # 可根据实际需要选择不同的引擎版本进行fire框架的构建 mvn clean install -DskipTests -Pspark-3.0 -Pflink-1.14 -Pscala-2.12Apache SparkApache Flink2.3.x1.12.x2.4.x1.13.x3.0.x1.14.x3.1.x1.15.x3.2.x1.16.x3.3.x1.17.x3.4.x1.18.x3.5.x1.19.x3.2 简单好用 Fire框架高度封装,屏蔽大量技术细节,许多connector仅需一行代码即可完成主要功能。同时Fire框架统一了spark与flink两大引擎常用的api,使用统一的代码风格即可实现spark与flink的代码开发。 HBase API // 读取HBase中指定rowkey数据并将结果集封装为DataFrame返回 val studentDF: DataFrame = this.fire.hbaseGetDF(hTableName, classOf[Student], getRDD) // 将指定数据集分布式插入到指定HBase表中 this.fire.hbasePutDF(hTableName, studentDF, classOf[Student]) JDBC API 通过注解配置数据源: @Jdbc(url = "jdbc:mysql://mysql-server:3306/fire", username = "root", password = "root") Spark示例: // 将DataFrame中指定几列插入到关系型数据库中,每100条一插入 df.jdbcBatchUpdate(insertSql, Seq("name", "age", "createTime", "length", "sex"), batch = 100) // 将查询结果通过反射映射到DataFrame中 val df: DataFrame = this.fire.jdbcQueryDF(querySql, Seq(1, 2, 3), classOf[Student]) Flink示例: val dstream = this.fire.createKafkaDirectStream().map(t => JSONUtils.parseObject[Student](t)) val sql = s""" |insert into spark_test(name, age, createTime) values(?, ?, ?) |ON DUPLICATE KEY UPDATE age=18 |""".stripMargin // sinkJdbc只需指定sql语句即可,fire会自动推断sql中占位符与JavaBean中成员变量的对应关系 dstream.sinkJdbc(sql) dstream.sinkJdbcExactlyOnce(sql, keyNum = 2)3.3 灵活的配置方式 支持基于接口、apollo、配置文件以及注解等多种方式配置,支持将spark&flink等引擎参数、fire框架参数以及用户自定义参数混合配置,支持运行时动态修改配置。几种常用配置方式如下(配置手册): 基于配置文件: 创建类名同名的properties文件进行参数配置 基于接口配置: fire框架提供了配置接口调用,通过接口获取所需的配置,可用于平台化的配置管理 基于注解配置: 通过注解的方式实现集群环境、connector、调优参数的配置,常用注解如下: @Config( """ |# 支持Flink调优参数、Fire框架参数、用户自定义参数等 |state.checkpoints.num-retained=30 |state.checkpoints.dir=hdfs:///user/flink/checkpoint |""") @Hive("thrift://localhost:9083") @Checkpoint(interval = 100, unaligned = true) @Kafka(brokers = "localhost:9092", topics = "fire", groupId = "fire") @RocketMQ(brokers = "bigdata_test", topics = "fire", groupId = "fire", tag = "*", startingOffset = "latest") @Jdbc(url = "jdbc:mysql://mysql-server:3306/fire", username = "root", password = "..root726") @HBase("localhost:2181")配置获取: Fire框架封装了统一的配置获取api,基于该api,无论是spark还是flink,无论是在Driver | JobManager端还是在Executor | TaskManager端,都可以一行代码获取所需配置。这套配置获取api,无需再在flink的map等算子中复写open方法了,用起来十分方便。 this.conf.getString("my.conf") this.conf.getInt("state.checkpoints.num-retained") ...3.4 多集群支持 Fire框架的配置支持N多集群,比如同一个任务中可以同时配置多个HBase、Kafka数据源,使用不同的数值后缀即可区分(keyNum): // 假设基于注解配置HBase多集群如下: @HBase("localhost:2181") @HBase2(cluster = "192.168.0.1:2181", storageLevel = "DISK_ONLY") // 代码中使用对应的数值后缀进行区分 this.fire.hbasePutDF(hTableName, studentDF, classOf[Student]) // 默认keyNum=1,表示使用@HBase注解配置的集群信息 this.fire.hbasePutDF(hTableName2, studentDF, classOf[Student], keyNum=2) // keyNum=2,表示使用@HBase2注解配置的集群信息3.5 常用connector支持 支持kafka、rocketmq、redis、HBase、Jdbc、clickhouse、Hive、hudi、tidb、adb等常见的connector。 3.6 checkpoint热修改 支持运行时动态调整checkpoint周期、超时时间、并行checkpoint等参数,避免任务重启时由于反压带来的checkpoint压力。 3.7 streaming热重启 该功能是主要用于Spark Streaming任务,通过热重启技术,可以在不重启Spark Streaming的前提下,实现批次时间的热修改。比如在web端将某个任务的批次时间调整为10s,会立即生效。 3.8 配置热更新 用户仅需在web页面中更新指定的配置信息,就可以让实时任务接收到最新的配置并且立即生效。最典型的应用场景是进行Spark任务的某个算子partition数调整,比如当任务处理的数据量较大时,可以通过该功能将repartition的具体分区数调大,会立即生效。 3.9 在线性能诊断 深度集成Arthas,可对运行中的任务动态进行性能诊断。fire为arthas诊断提供rest接口,可通过接口调用的方式选择为driver、jobmanager或executor、taskmanager动态开启与关闭arthas诊断线程,然后向统一的arthas tunnel服务注册,即可在网页端输入arthas命令进行性能诊断。 arthas-shell 3.10 sql在线调试 Fire框架对外暴露了restful接口,平台等系统可通过接口调用的方式将待执行的sql语句动态传递给fire,由fire将sql提交到对应的引擎,并将sql执行结果通过接口调用的方式返回,实现实时任务sql开发的在线调试,避免重复修改代码发布执行带来的时间成本。 3.11 实时血缘 Fire框架支持运行时统计分析每个任务所使用到的数据源信息、库表信息、操作类型等,并将这些血缘信息通过接口的方式对外暴露。实时平台等web系统通过接口调用的方式即可获取到实时血缘信息。截止目前,Fire框架支持高达30多种主流connector的血缘解析,包括:paimon、hudi、doris、hive、jdbc、StarRocks、HBase等等。Fire框架会将解析的血缘拼接成json格式,通过配置的地址周期性发送到指定的kafka topic中,下游实时平台消费血缘信息并做展示即可。 fire血缘架构 Fire框架同时支持**Spark**与**Flink**两大流式计算引擎的血缘解析,可实现全面洞悉数据流转链路、打通离线与实时计算的血缘形成闭环、还可协助快速定位线上的问题。 fire血缘展示 3.12 定时调度 Fire框架内部封装了quartz框架,实现通过Scheduled注解即可完成定时任务的注册。 /** * 声明了@Scheduled注解的方法是定时任务方法,会周期性执行 * * @scope 默认同时在driver端和executor端执行,如果指定了driver,则只在driver端定时执行 * @initialDelay 延迟多长时间开始执行第一次定时任务 */ @Scheduled(cron = "0/5 * * * * ?", scope = "driver", initialDelay = 60000) def loadTable: Unit = { this.logger.info("更新维表动作") }3.13 平台无缝集成 Fire框架内置restful服务,并将许多功能通过接口的方式对外暴露,实时平台可以通过fire框架暴露的接口实现与每个实时任务的信息连接。 3.14 fire-shell Fire框架整合spark shell与flink shell,支持通过REPL方式去动态调试spark和flink任务,并且支持fire框架的所有API。fire框架将shell能力通过接口方式暴露给实时平台,如此一来就可以通过web页面去调试spark和flink任务了。 四、升级日志 五、期待你的加入 社区技术交流:35373471(钉钉) 入群请备注:公司名称-岗位-昵称,否则不予理会 项目截图 项目截图 ⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/fire-framework/fire/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
kwdb {card-default label="? 项目信息"} ? 项目名称:kwdb ? 开发语言:None ⭐ Star数:1613 | ? Fork数:1240 ? 开源协议:None ? 项目地址:https://gitee.com/kwdb/kwdb {/card-default} 项目介绍 KWDB 是一款面向 【AIoT 场景】的【分布式多模数据库】,支持在同一实例同时建立时序库和关系库并融合处理多模数据,具备千万级设备接入、百万级数据秒级写入、亿级数据秒级读取等时序数据高效处理能力,具有稳定安全、高可用、易运维等特点。 项目详情 KWDB 简体中文 | English 了解 KWDB KWDB 是开放原子开源基金会孵化及运营的面向 AIoT 物联网场景的分布式多模数据库项目。基于浪潮 KaiwuDB 开源,支持在同一实例同时建立时序库和关系库并融合处理多模数据,具备千万级设备接入、百万级数据秒级写入、亿级数据秒级读取等时序数据高效处理能力,具有稳定安全、高可用、易运维等特点。典型应用场景包括但不限于物联网、能源电力、交通车联网等,旨在为各行业领域提供一站式数据存储、管理与分析的基座,助力企业数智化建设,以更低的成本挖掘更大的数据价值。 KWDB 适配多种场景,为开发者提供: 多种通用连接接口,具备高速写入、极速查询、SQL 支持、随需压缩、数据生命周期管理、集群部署等特性,与第三方工具无缝集成,降低开发及学习难度,提升开发使用效率。 快速安装部署、升级、迁移、监控等能力,提升数据库运维效率,降低数据库运维管理成本。 数据库可视化管理工具、时序数据库基准测试工具、监控指标模板等多种生态工具。 MCP Server、AI 智能助手和 AI 智能体等多种 AI 赋能工具,帮助用户更高效、更智能的开发和维护 KWDB。 关键词:物联网(IoT)、多模数据库、分布式、时序数据处理、云边端协同 快速开始 推荐使用 Docker 快速体验 KWDB: docker run -d --privileged --name kwdb \ -p 26257:26257 \ -p 8080:8080 \ -v /var/lib/kaiwudb:/kaiwudb/deploy/kaiwudb-container \ --ipc shareable \ -w /kaiwudb/bin \ kwdb/kwdb \ ./kwbase start-single-node \ --insecure \ --listen-addr=0.0.0.0:26257 \ --http-addr=0.0.0.0:8080 \ --store=/kaiwudb/deploy/kaiwudb-containerkwbase 是 KWDB 提供的内置命令行工具,用户可以通过 kwbase 连接 KaiwuDB,进行数据库操作和维护。 使用 Docker 连接 KWDB 并开启交互式 SQL Shell: docker exec -it kwdb ./kwbase sql --insecure --host=127.0.0.1编译和安装 KWDB 支持用户根据需求选择二进制安装包、容器和源码安装 KWDB 数据库: 二进制安装包:前往KaiwuDB 官网下载二进制安装包,支持单机和集群以及安全和非安全部署模式,更多信息见快速部署和集群部署。 容器镜像:KWDB 提供了多种容器镜像下载渠道,用户可以根据当前网络环境选择合适的镜像。 官方仓库:kwdb/kwdb 国内镜像:crpi-9ix5pwqh4t79xf4r.cn-shanghai.personal.cr.aliyuncs.com/kaiwudb/kwdb Github 容器镜像:ghcr.io/kwdb/kwdb 源码:源码编译目前支持单节点非安全模式部署。 以下指南以 Ubuntu 22.04 操作系统为例说明如何编译源码和安装 KWDB。 操作系统和软件依赖 KWDB 支持在 Linux 操作系统进行安装部署,下表列出了编译和运行 KWDB 所需的软件依赖。 编译依赖: 依赖版本说明ca-certificatesany Gov1.15+ CMakev3.23 Autoconfv2.68+ goyaccv0.8.0+ dpkg-devany仅适用Ubuntu系统。devscriptsany仅适用Ubuntu系统。build-essentialany checkinstallany libsslv1.1.1+- Ubuntu系统该依赖名为libssl-dev。- RHEL, CentOS, Kylin, UOS, AnolisOS系统该依赖名为libssl-devel。libprotobufv3.6.1+- Ubuntu系统该依赖名为libprotobuf-dev。- RHEL, CentOS, Kylin, UOS, AnolisOS系统该依赖名为libprotobuf-devel。liblzmav5.2.0+- Ubuntu系统该依赖名为liblzma-dev。- RHEL, CentOS, Kylin, UOS, AnolisOS系统该依赖名为liblzma-devel。libncursesv6.2.0+- Ubuntu系统该依赖名为libncurses5-dev。- RHEL, CentOS, Kylin, UOS, AnolisOS系统该依赖名为libncurses-devel。libatomicv7.3.0+仅 GCC 和 G++ 7.3.0 版本需要增加此依赖。libstdc++-staticv7.3.0+仅 GCC 和 G++ 7.3.0 版本需要增加此依赖。protobuf-compilerany gitany libprotoc-devv3.6.1+- Ubuntu系统该依赖名为libprotoc-dev。- RHEL, CentOS, Kylin, UOS, AnolisOS系统该依赖名为libprotobuf-devel。gflagsV2.2.2 libz4V1.9.2 运行依赖: 依赖版本opensslv1.1.1+libprotobufv3.6.1+ 注意:Ubuntu 18.04 默认的 libprotobuf 版本不满足要求,用户需要提前安装所需版本(推荐 3.6.1 和 3.12.4),并在编译时通过 make PROTOBUF_DIR= 指定高版本路径。geosv3.3.8+xz-libsv5.2.0+squashfs-toolsanylibgccv7.3.0+mountanysquashfuseany环境准备 下载和解压 CMake 安装包。 tar -C /usr/local/ -xvf cmake-3.23.4-linux-x86_64.tar.gz mv /usr/local/cmake-3.23.4-linux-x86_64 /usr/local/cmake 下载和解压 Go 安装包。 tar -C /usr/local -xvf go1.22.5.linux-amd64.tar.gz 创建用于存放项目代码的代码目录。 mkdir -p /home/go/src/gitee.com 设置 Go 和 CMake 的环境变量。 个人用户设置:修改~/.bashrc 文件 系统全局设置(需要 root 权限):修改/etc/profile文件 export GOROOT=/usr/local/go export GOPATH=/home/go #请以实际代码下载存放路径为准,在此以home/go目录为例 export PATH=$PATH:/usr/local/go/bin:/usr/local/cmake/bin 使变量设置立即生效: 个人用户设置: source ~/.bashrc - 系统全局设置: source /etc/profile 下载代码 在 KWDB 代码仓库下载代码,并将其存储到 GOPATH 声明的目录。 使用 git clone 命令: git clone https://gitee.com/kwdb/kwdb.git /home/go/src/gitee.com/kwbasedb #请勿修改目录路径中的 src/gitee.com/kwbasedb cd /home/go/src/gitee.com/kwbasedb git submodule update --init #适用于首次拉取代码 git submodule update --remote 下载代码压缩包,并将其解压缩到指定目录。 构建和安装 在项目目录下创建并切换到构建目录。 cd /home/go/src/gitee.com/kwbasedb mkdir build && cd build 运行 CMake 配置。 cmake .. -DCMAKE_BUILD_TYPE= [Release | Debug]参数说明: CMAKE_BUILD_TYPE:指定构建类型,默认为 Debug。可选值为 Debug 或 Release,首字母需大写。 禁用Go模块功能。 设置环境变量 个人用户设置:修改~/.bashrc 文件 系统全局设置(需要 root 权限):修改/etc/profile文件 export GO111MODULE=off 使变量设置立即生效: 个人用户设置: source ~/.bashrc 系统全局设置: source /etc/profile 编译和安装项目。 提示: 如果编译时出现遗留的 protobuf 自动生成的文件导致报错,可使用make clean 清理编译目录。 如果需要额外指定 protobuf 的文件路径,请使用 make PROTOBUF_DIR=。 make make install编译和安装成功后的文件清单如下: /home/go/src/gitee.com/kwbasedb ├── install │ ├── bin │ │ ├── err_inject.sh │ │ ├── query_kwbase_status.sh │ │ ├── query_status.sh │ │ ├── setup_cert_file.sh │ │ ├── utils.sh │ │ └── kwbase │ └── lib │ ├── libcommon.so │ └── libkwdbts2.so (可选)进入 kwbase 脚本所在目录,查看数据库版本,验证是否安装成功。 ./kwbase version KaiwuDB Version: V2.0.3.2_RC3-3-gfe5eeb853e-dirty Build Time: 2024/07/19 06:24:00 Distribution: Platform: linux amd64 (x86_64-linux-gnu) Go Version: go1.22.5 C Compiler: gcc 11.4.0 Build SHA-1: fe5eeb853e0884a963fd43b380a0b0057f88fb19启动数据库 进入 kwbase 脚本所在目录。 cd /home/go/src/gitee.com/kwbasedb/install/bin 设置共享库的搜索路径。 export LD_LIBRARY_PATH=../lib 启动数据库。 ./kwbase start-single-node --insecure --listen-addr=:26257 --background 数据库启动后即可通过 kwbase CLI 工具、KaiwuDB 开发者中心或 JDBC 等连接器连接和使用 KWDB,具体连接和使用内容见使用 kwbase CLI 工具连接 KWDB、使用 KaiwuDB 开发者中心连接 KWDB 和使用 JDBC 连接 KWDB。 社区 欢迎广大社区用户及开源爱好者 Star & Fork KWDB,并踊跃参与到我们的社区活动之中,携手共同建设社区。若需了解详情,请查阅我们的社区贡献相关内容。开发者可通过 Issue)、PR 以及技术交流群等方式展开沟通协作,助力社区实现更为良好的发展。 案例 KWDB 典型应用场景包括但不限于物联网、能源电力、交通车联网、智慧政务、IT 运维、金融证券等,更多信息请参见应用案例。 发版说明 请参见发版说明。 许可证 本项目根据 MulanPSL2 许可证授权。 声明 KWDB 是由开放原子开源基金会(OpenAtom Foundation)孵化及运营的开源项目。 项目截图 合作交流 如果你想和更多 KWDB 的用户互动交流,请扫下方二维码(备注:Gitee),KWDB 官方小助手将协助你加入官方技术交流群。 官方渠道 官网:https://www.kaiwudb.com 开源运营专区:https://kwdb.atomgit.com 公众号:KaiwuDB ⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/kwdb/kwdb/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
MilvusPlus {card-default label="? 项目信息"} ? 项目名称:MilvusPlus ? 开发语言:Java ⭐ Star数:533 | ? Fork数:132 ? 开源协议:Apache-2.0 ? 项目地址:https://gitee.com/dromara/MilvusPlus {/card-default} 项目介绍 ???使用MyBatisPlus的方式,优雅的操作向量数据库 Milvus,同时支持spring和solon 项目详情 Dromara MilvusPlus:向量数据库增强操作库 项目简介 项目截图 ???MilvusPlus(简称 MP)是一个 Milvus 的操作工具,旨在简化与 Milvus 向量数据库的交互,为开发者提供类似 MyBatis-Plus 注解和方法调用风格的直观 API,提高效率而生。特性 无侵入:只做增强不做改变,引入它不会对现有工程产生影响,如丝般顺滑 损耗小:启动即会自动注入基本 CURD,性能基本无损耗,直接面向对象操作 强大的 CRUD 操作:通用 MilvusMapper,仅仅通过少量配置即可实现 CRUD 操作,更有强大的条件构造器,满足各类使用需求 直观的 API:直接的 API 设计简化数据库操作,MilvusService 提供丰富的API。 支持 Lambda 形式调用:通过 Lambda 表达式,方便的编写各类查询条件,无需再担心字段写错 支持主键自动生成:完美解决主键问题 支持自定义全局通用操作:支持全局通用方法注入 注解式配置:采用与 MyBatis-Plus 类似的注解方式配置实体模型。 易于扩展:核心设计注重可扩展性。 类型安全:利用 Java 类型安全减少错误。 快速开始 自定义扩展支持: org.dromara.milvus-plus milvus-plus-core 2.3.0 Spring应用支持: org.dromara.milvus-plus milvus-plus-boot-starter 2.3.0 Solon应用支持: org.dromara.milvus-plus milvus-plus-solon-plugin 2.3.0 需知 2.3.0 版本升级官方 milvus-sdk-java 至 3.0.4(对齐 Milvus 3.0.x 服务端),并修复 addField / Gson / 搜索参数等已知问题 2.3.0 详细使用指南(推荐阅读) → docs/2.3.0-使用指南.md 变更清单 → CHANGELOG.md 本地 Docker → docker/README.md 2.2.0版本支持数据库版本2.5.x,增强文本搜索能力 2.1.7版本之后groupId修改为 org.dromara.milvus-plus,版本之前为 org.dromara 2.0.0版本必须使用索引注解定义索引,不然启动报错后,再添加无效,需要先删除集合 2.0.0版本暂未发布 MilvusService 功能 配置文件 milvus: uri: https://in03-a5357975ab80da7.api.gcp-us-west1.zillizcloud.com token: x'x'x'x enable: true open-log: true (默认 false 不打印) db-name: (可选) username: (可选) password: (可选) # 集合结构同步:IGNORE(默认兼容) / VALIDATE / AUTO_ADD(推荐新项目) / RECREATE(危险) schema-mode: AUTO_ADD # 仅 schema-mode=RECREATE 时生效,生产务必 false enable-recreate: false packages: - com.example.entity milvus:定义了与Milvus服务相关的配置。 uri:Milvus服务的URI,应用程序通过这个URI与Milvus服务进行通信。 token:用于验证和授权的令牌(Token),确保访问Milvus服务的安全性。 enable:一个布尔值,用于指示Milvus模块是否应该被启用。 packages:这些包包含了自定义注解对应的Java类,你可以认为这是你自定义的实体类所在的包。 schema-mode:实体注解与服务端 collection 的同步策略。 enable-recreate:是否允许 RECREATE 删表重建。 2.3.0 快速示例 // 1) 自动补齐实体新增字段 milvusService.ensureSchema(Face.class); // 2) 动态集合(分表/租户) faceMapper.forCollection("face_" + tenantId).insert(face); // 3) 语义化向量检索 faceMapper.queryWrapper() .vectorSearch(Face::getFaceVector, embedding) .eq(Face::getPersonName, "张三") .top(10) .options(opt -> opt.metricType(IndexParam.MetricType.IP)) .query(); // 4) 文本检索(BM25,无需手写 _sparse) faceMapper.queryWrapper() .textSearch(Face::getContent, "关键词") .top(10) .query(); // 5) 标量分页 faceMapper.queryWrapper().eq(Face::getStatus, 1).page(1, 20); // 6) 部分更新 faceMapper.updateWrapper().partial().updateById(face); // 7) 类 SQL WHERE(实验子集,不是完整 MySQL) faceMapper.queryWrapper() .sqlWhere("status = 1 AND name LIKE '%张%' OR type IN ('A','B')") .top(10) .query(); // 8) 原生滤器表达式(Milvus boolean expression) faceMapper.queryWrapper() .filter("status == 1 && array_contains(tags, \"vip\")") .query();本地 Docker 测试 cd docker docker compose up -d # uri: http://localhost:19530详见 docker/README.md。 应用场景 相似性搜索:快速检索与给定向量最相似的项。 推荐系统:根据用户行为和偏好推荐相关内容。 图像检索:在大规模图像库中找到与查询图像最相似的图像。 自然语言处理:将文本转换为向量并执行语义搜索。 生物信息学:分析和比较生物序列,如蛋白质和基因组数据。 自定义注解详解 使用自定义注解自动化Milvus数据库集成,提供了以下显著优势: 简化开发流程:通过注解直接在代码中声明数据库结构,不用手动创建集合、属性、索引、分区,项目启动即自动构建,减少手动编写Milvus API调用的需要。 提高开发效率:注解驱动的方式使得数据库结构的创建和管理更加快捷,加快开发速度。 增强代码可读性:将数据库结构定义与业务逻辑代码紧密结合,提高代码的可读性和可维护性。 减少错误:自动化创建数据库结构减少了人为错误的可能性,提高了系统的稳定性。 易于维护:注解的使用使得数据库结构的变更更加集中和明确,便于后期维护和升级。 @ExtraParam 注解 用途:定义索引或其他自定义功能的额外参数。 属性: key(): 参数的键名。 value(): 参数的值。 @MilvusCollection 注解 用途:定义Milvus数据库中的集合。 属性: name(): 集合的名称。 @MilvusField 注解 用途:定义Milvus集合中的字段。 属性: name(): 字段名称,默认为Java字段名。 dataType(): 数据类型,默认为FLOAT_VECTOR。 dimension(): 向量维度,默认为-1。 isPrimaryKey(): 是否为主键,默认为false。 autoID(): 是否自动生成ID,默认为false。 description(): 字段描述,默认为空。 elementType(): 元素类型,默认为None。 maxLength(): 最大长度,默认为-1。 maxCapacity(): 最大容量,默认为-1。 isPartitionKey(): 是否为分区键,默认为false。 @MilvusIndex 注解 用途:定义Milvus集合中的索引。 属性: indexType(): 索引类型,默认为FLAT。 metricType(): 度量类型,默认为L2。 indexName(): 索引名称,默认为空。 extraParams(): 额外参数,使用ExtraParam注解定义。 @MilvusPartition 注解 用途:定义Milvus集合的分区。 属性: name(): 分区的名称数组。 通过这些注解,开发者可以轻松地定义和管理Milvus数据库的结构,实现项目启动时自动构建所需数据库结构的目标。 索引与度量类型详解 索引类型(IndexType) INVALID:无效索引类型,仅用于内部标记。 FLAT:暴力搜索,适用于小规模数据集。 IVF_FLAT:倒排索引平面模式,适用于中等规模数据集。 IVF_SQ8:倒排索引量化模式,适用于大规模数据集,牺牲精度提升速度。 IVF_PQ:倒排索引产品量化模式,适用于大规模高维数据集,平衡速度和精度。 HNSW:分层导航小世界图,提供快速搜索,适用于大规模数据集。 DISKANN:基于磁盘的近似最近邻搜索,适用于存储在磁盘上的大规模数据集。 AUTOINDEX:自动选择最优索引类型。 SCANN:使用扫描和树结构加速搜索。 GPU_IVF_FLAT、GPU_IVF_PQ:GPU 加速索引,适用于 GPU 环境。 BIN_FLAT、BIN_IVF_FLAT:二进制向量专用索引。 TRIE:适用于字符串类型的字典树索引。 STL_SORT:适用于标量字段的排序索引。 度量类型(MetricType) INVALID:无效度量类型,仅用于内部标记。 L2:欧几里得距离,适用于浮点向量。 IP:内积,用于计算余弦相似度。 COSINE:余弦相似度,适用于文本和图像搜索。 HAMMING:汉明距离,适用于二进制向量。 JACCARD:杰卡德相似系数,适用于集合相似度计算。 MilvusMapper 功能 MilvusMapper 是一个用于操作 Milvus 数据库的通用接口,提供了一系列的数据操作方法,包括查询、删除、更新和插入。以下是对 MilvusMapper 及其相关类的功能描述: MilvusMapper MilvusMapper 是一个泛型抽象类,继承自 BaseMilvusMapper,提供了与 Milvus 客户端交互的基本方法。 获取 Milvus 客户端: getClient() - 返回 MilvusClientV2 实例。 BaseMilvusMapper BaseMilvusMapper 是一个抽象类,定义了与 Milvus 数据库交互的基础操作。 创建搜索构建器实例: queryWrapper() - 创建 LambdaQueryWrapper 实例。 创建删除构建器实例: deleteWrapper() - 创建 LambdaDeleteWrapper 实例。 创建更新构建器实例: updateWrapper() - 创建 LambdaUpdateWrapper 实例。 创建新增构建器实例: insertWrapper() - 创建 LambdaInsertWrapper 实例。 数据操作 通过 ID 获取数据getById(Serializable ... ids) 功能:根据提供的ID列表查询数据。 `参数`:`ids` - 一个可序列化的ID列表。 `返回`:`MilvusResp>>` - 包含查询结果的响应。 删除数据removeById(Serializable ... ids) 功能:根据提供的ID列表删除数据。 `参数`:`ids` - 一个可序列化的ID列表。 `返回`:`MilvusResp` - 删除操作的响应。 更新数据updateById(T ... entity) 功能:根据提供的实体更新数据。 `参数`:`entity` - 一个实体对象列表。 `返回`:`MilvusResp` - 更新操作的响应。 插入数据insert(T ... entity) `功能`:插入提供的实体到数据库。 `参数`:`entity` - 一个实体对象列表。 `返回`:`MilvusResp` - 插入操作的响应。 构建器方法 创建通用构建器实例: lambda(Wrapper wrapper) - 初始化并返回构建器实例。 LambdaQueryWrapper 类功能文档 LambdaQueryWrapper 是一个用于构建和执行 Milvus 搜索查询的构建器类。它提供了一系列方法来设置查询参数,并最终执行查询。 构造函数 LambdaQueryWrapper(): 无参构造函数。 LambdaQueryWrapper(String collectionName, MilvusClientV2 client, ConversionCache conversionCache, Class entityType): 构造函数,初始化集合名称、Milvus 客户端、类型转换缓存和实体类型。 分区设置 partition(String ... partitionName): 添加一个或多个分区名称到查询中。 partition(FieldFunction... partitionName): 根据提供的字段函数添加分区名称。 搜索参数设置 searchParams(Map searchParams): 设置搜索参数。 以下是 searchParams 支持的参数及其说明: metric_type 类型:String 描述:指定搜索操作使用的度量类型。必须与索引向量字段时使用的度量类型一致。 可选值: L2:欧几里得距离,适用于高维空间的向量搜索。 IP:内积,适用于余弦相似度搜索。 COSINE:余弦相似度,与内积相同,适用于测量向量间的夹角。 示例: searchParams.put("metric_type", "L2"); radius 类型:float 描述:设置搜索操作的最小相似度阈值。当 metric_type 设置为 L2 时,此值应大于 range_filter;否则,应小于 range_filter。 示例: searchParams.put("radius", 0.5f); range_filter 类型:float 描述:限定搜索操作的相似度范围。当 metric_type 设置为 IP 或 COSINE 时,此值应大于 radius;否则,应小于 radius。 示例: searchParams.put("range_filter", 0.3f); 使用示例 以下是一个使用 searchParams 的示例,展示如何构建搜索请求并设置特定的搜索参数: Map searchParams = new HashMap<>(); searchParams.put("metric_type", "L2"); searchParams.put("radius", 0.5f); searchParams.put("range_filter", 0.3f); radius(Object radius): 设置搜索半径。 rangeFilter(Object rangeFilter): 设置范围过滤器。 metricType(Object metric_type): 设置度量类型。 结果设置 outputFields(List outputFields): 设置要返回的字段。 roundDecimal(int roundDecimal): 设置返回的距离值的小数位数。 查询条件构建 eq(String fieldName, Object value): 添加等于条件。 ne(String fieldName, Object value): 添加不等于条件。 gt(String fieldName, Object value): 添加大于条件。 ge(String fieldName, Object value): 添加大于等于条件。 lt(String fieldName, Object value): 添加小于条件。 le(String fieldName, Object value): 添加小于等于条件。 between(String fieldName, Object start, Object end): 添加范围条件。 isNull(String fieldName): 添加空值检查条件。 isNotNull(String fieldName): 添加非空值检查条件。 in(String fieldName, List values): 添加 IN 条件。 like(String fieldName, String value): 添加 LIKE 条件。 JSON 和数组操作 jsonContains(String fieldName, Object value): 添加 JSON 包含条件。 jsonContainsAll(String fieldName, List values): 添加 JSON 包含所有值的条件。 jsonContainsAny(String fieldName, List values): 添加 JSON 包含任意值的条件。 arrayContains(String fieldName, Object value): 添加数组包含条件。 arrayContainsAll(String fieldName, List values): 添加数组包含所有值的条件。 arrayContainsAny(String fieldName, List values): 添加数组包含任意值的条件。 arrayLength(String fieldName, int length): 添加数组长度条件。 逻辑操作 and(ConditionBuilder other): 添加 AND 条件。 or(ConditionBuilder other): 添加 OR 条件。 not(): 添加 NOT 条件。 向量搜索设置 annsField(String annsField): 设置要搜索的向量字段。 vector(List vector): 添加要搜索的向量。 vector(String annsField, List vector): 设置向量字段并添加要搜索的向量。 topK(Integer topK): 设置返回的 top-k 结果。 limit(Long limit): 设置查询结果的数量限制。 执行查询 query(): 构建并执行搜索请求,返回封装的 MilvusResp 对象,其中包含查询结果。 query(FieldFunction ... outputFields): 设置输出字段并执行查询。 query(String ... outputFields): 设置输出字段并执行查询。 getById(Serializable ... ids): 通过 ID 获取数据。 辅助方法 buildSearch(): 构建完整的搜索请求对象。 buildQuery(): 构建查询请求对象。 LambdaQueryWrapper 类提供了丰富的方法来构建复杂的搜索查询,支持各种条件、逻辑操作、JSON 和数组操作,以及向量搜索。通过链式调用这些方法,用户可以灵活地构造搜索请求并获取所需的查询结果。 LambdaDeleteWrapper LambdaDeleteWrapper 是一个构建器类,用于构建和执行删除操作。 添加分区: partition(String partitionName) 添加等于条件: eq(String fieldName, Object value) 添加不等于条件: ne(String fieldName, Object value) 添加 ID 到删除列表: id(Object id) 执行删除 执行删除: remove() - 构建并执行删除请求。 通过 ID 删除: removeById(Serializable ... ids) LambdaUpdateWrapper LambdaUpdateWrapper 是一个构建器类,用于构建和执行更新操作。 添加分区: partition(String partitionName) 设置更新条件: 与 LambdaDeleteWrapper 相同 执行更新 更新数据: update(T t) - 构建并执行更新请求。 通过 ID 更新: updateById(T ... t) LambdaInsertWrapper LambdaInsertWrapper 是一个构建器类,用于构建和执行插入操作。 添加分区: partition(String partitionName) 添加字段值: put(String fieldName, Object value) 执行插入 插入数据: insert() - 构建并执行插入请求。 插入多个数据: insert(T ... t) MilvusService 功能 MilvusService 是一个综合性服务,提供对 Milvus 数据库的全面管理,它实现了多个接口:IAMService(身份访问管理服务)、ICMService(集合管理服务)和 IVecMService(向量管理服务)。 身份访问管理 (IAMService) IAMService 接口提供用户和角色的创建、删除、查询以及权限的授予和撤销等功能。 创建角色: createRole(String roleName) 创建用户: createUser(String userName, String password) 查询角色权限: describeRole(String roleName) 查询用户信息: describeUser(String userName) 删除角色: dropRole(String roleName) 删除用户: dropUser(String userName) 授予角色权限: grantPrivilege(String roleName, String objectType, String privilege, String objectName) 授予用户角色: grantRole(String roleName, String userName) 列出所有角色: listRoles() 列出所有用户: listUsers() 撤销角色权限: revokePrivilege(String roleName, String objectType, String privilege, String objectName, String databaseName) 撤销用户角色: revokeRole(String roleName, String userName) 更新用户密码: updatePassword(String userName, String password, String newPassword) 集合管理 (ICMService) ICMService 接口提供集合的创建、删除、查询、重命名、索引创建和管理等功能。 创建集合: createCollection(MilvusEntity milvusEntity) 添加字段: addField(String collectionName, AddFieldReq ... addFieldReq) 获取字段: getField(String collectionName, String fieldName) 获取集合详细信息: describeCollection(String collectionName) 删除集合: dropCollection(String collectionName) 检查集合是否存在: hasCollection(String collectionName) 获取集合统计信息: getCollectionStats(String collectionName) 重命名集合: renameCollection(String oldCollectionName, String newCollectionName) 为集合创建索引: createIndex(String collectionName, List indexParams) 获取集合索引信息: describeIndex(String collectionName, String fieldName) 删除集合索引: dropIndex(String collectionName, String fieldName) 获取集合或分区的加载状态: getLoadState(String collectionName, String partitionName) 加载集合数据到内存: loadCollection(String collectionName) 从内存中释放集合数据: releaseCollection(String collectionName) 创建集合分区: createPartition(String collectionName, String partitionName) 删除集合分区: dropPartition(String collectionName, String partitionName) 检查分区是否存在: hasPartition(String collectionName, String partitionName) 列出集合中的所有分区: listPartitions(String collectionName) 加载集合分区到内存: loadPartitions(String collectionName, List partitionNames) 从内存中释放集合分区: releasePartitions(String collectionName, List partitionNames) 向量管理 (IVecMService) IVecMService 接口提供向量的插入、更新、查询、删除以及相似性搜索等功能。 删除实体: delete(String collectionName, String partitionName, String filter, List ids) 根据ID获取实体: get(String collectionName, String partitionName, List ids, List outputFields) 插入数据: insert(String collectionName, List data, String partitionName) 根据标量过滤条件查询: query(String collectionName, List partitionNames, List outputFields, List ids, String filter, ConsistencyLevel consistencyLevel, long offset, long limit) 执行向量相似性搜索: search(String collectionName, List partitionNames, String annsField, int topK, String filter, List outputFields, List data, long offset, long limit, int roundDecimal, Map searchParams, long guaranteeTimestamp, long gracefulTime, ConsistencyLevel consistencyLevel, boolean ignoreGrowing) 插入或更新数据: upsert(String collectionName, String partitionName, List data) 公共方法 除了上述功能,MilvusService 还提供了一个公共方法来获取 MilvusClientV2 实例: 获取 Milvus 客户端: `getClient() 使用案例 以下是使用 MilvusPlus 进行向量搜索的示例: @Data @MilvusCollection(name = "face_collection") // 指定Milvus集合的名称 public class Face { @MilvusField( name = "person_id", // 字段名称 dataType = DataType.Int64, // 数据类型为64位整数 isPrimaryKey = true, // 标记为主键 ) private Long personId; // 人员的唯一标识符 @MilvusField( name = "face_vector", // 字段名称 dataType = DataType.FloatVector, // 数据类型为浮点型向量 dimension = 128, // 向量维度,假设人脸特征向量的维度是128 ) @MilvusIndex( indexType = IndexParam.IndexType.IVF_FLAT, // 使用IVF_FLAT索引类型 metricType = IndexParam.MetricType.L2, // 使用L2距离度量类型 indexName = "face_index", // 索引名称 extraParams = { // 指定额外的索引参数 @ExtraParam(key = "nlist", value = "100") // 例如,IVF的nlist参数 } ) private List faceVector; // 存储人脸特征的向量 } @Component public class FaceMilvusMapper extends MilvusMapper { } @Component @Slf4j public class ApplicationRunnerTest implements ApplicationRunner { private final FaceMilvusMapper mapper; public ApplicationRunnerTest(FaceMilvusMapper mapper) { this.mapper = mapper; } @Override public void run(ApplicationArguments args){ Face f ...(内容过长,已截断,更多详情请访问项目地址) ## ⬇️ 下载地址 ## {cloud type="default" title="网盘下载" url="https://gitee.com/dromara/MilvusPlus/repository/archive/master.zip"}
-
Taro {card-default label="? 项目信息"} ? 项目名称:Taro ? 开发语言:JavaScript ⭐ Star数:1129 | ? Fork数:219 ? 开源协议:MIT ? 项目地址:https://gitee.com/o2team/Taro {/card-default} 项目介绍 开放式跨端跨框架解决方案,支持使用 React/Vue/Nerv 等框架来开发微信/京东/百度/支付宝/字节跳动/ QQ 小程序/H5/React Native/鸿蒙 等应用。 https://taro.zone/ 项目详情 Taro 开放式跨端跨框架解决方案,轻松构建可以运行在 小程序/Web/APP 上的应用 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 简体中文 | English ? Taro['tɑ:roʊ],泰罗·奥特曼,宇宙警备队总教官,实力最强的奥特曼。目录 简介 学习资源 社区共享 项目状态 使用案例 加入共建 问题反馈与建议 特别鸣谢 贡献者们 开发计划 更新日志 开发交流 简介 开放式跨端跨框架解决方案,支持使用 React/Vue/Nerv 等框架来开发微信/京东/百度/支付宝/字节跳动/ QQ 小程序/H5/React Native 等应用。现如今市面上端的形态多种多样,Web、React Native、微信小程序等各种端大行其道,当业务要求同时在不同的端都要求有所表现的时候,针对不同的端去编写多套代码的成本显然非常高,这时候只编写一套代码就能够适配到多端的能力就显得极为需要 版本迁移 Taro 1/2 迁移至 Taro 3,请阅读《Taro 版本升级权威指南》 学习资源 5 分钟上手 Taro 开发 awesome-taro 社区共享 Taro 物料市场——让每一个轮子产生价值 UI 库 名称地址介绍支持的框架支持的 Taro 版本taro-uihttps://taro-ui.jd.com/#/一套基于 Taro 框架开发的多端 UI 组件库ReactTaro 1/2/3NutUIhttps://nutui.jd.com/#/京东风格的轻量级移动端 Vue 组件库Vue3Taro 3taroifyhttps://taroify.github.io/taroify.com/introduce/轻量、可靠的小程序端 Taro 组件库(Vant 的 Taro 版本)ReactTaro 3@antmjs/vantuihttps://antmjs.github.io/vantui/#/home基于有赞 VantWeapp 开发的同时支持 Taro 和 React 的 UI 库ReactTaro 3Tardhttps://tard-ui.selling.cn/一套基于 Taro 框架开发的多端 React UI 组件库ReactTaro 3duxuihttps://duxapp.cn/docs/duxui/start/一套能同时兼容小程序、React Native、鸿蒙、H5的移动端ui组件库ReactTaro 4项目状态 title= 使用案例 Taro 已经投入了我们的生产环境中使用,业界也在广泛地使用 Taro 开发多端应用。 项目截图 征集更多优秀案例 加入共建 加入 Taro 社区共建倡议 Taro 邀你加入社区共建 为 Taro 贡献代码 Taro 非常欢迎社区开发者为 Taro 贡献代码,在贡献之前请先阅读贡献指南。 如果你想为 Taro 实现一个重要功能,需要先撰写 RFC 文档,按照 Taro 的RFC 机制进行操作,在经过社区讨论完善后才可以进行代码的提交。 问题反馈与建议 给 Taro 提 ISSUE 强烈推荐阅读 《提问的智慧》、《如何向开源社区提问题》 和 《如何有效地报告 Bug》、《如何向开源项目提交无法解答的问题》,更好的问题更容易获得帮助。Let's fund issues in this repository 特别鸣谢 nanjingboyjsNewbeeQiyu8Garfield550nanjingboyjsNewbeeQiyu8Garfield Lee贡献者们 项目截图 开发计划 Milestones 更新日志 本项目遵从 Angular Style Commit Message Conventions,更新日志请查阅 Release。 开发交流 官方交流微信群 License MIT License Copyright (c) O2Team Permission is hereby granted, free of charge, to any person obtaining a copy of this software and associated documentation files (the "Software"), to deal in the Software without restriction, including without limitation the rights to use, copy, modify, merge, publish, distribute, sublicense, and/or sell copies of the Software, and to permit persons to whom the Software is furnished to do so, subject to the following conditions: The above copyright notice and this permission notice shall be included in all copies or substantial portions of the Software. THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY, FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM, OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE SOFTWARE. ⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/o2team/Taro/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
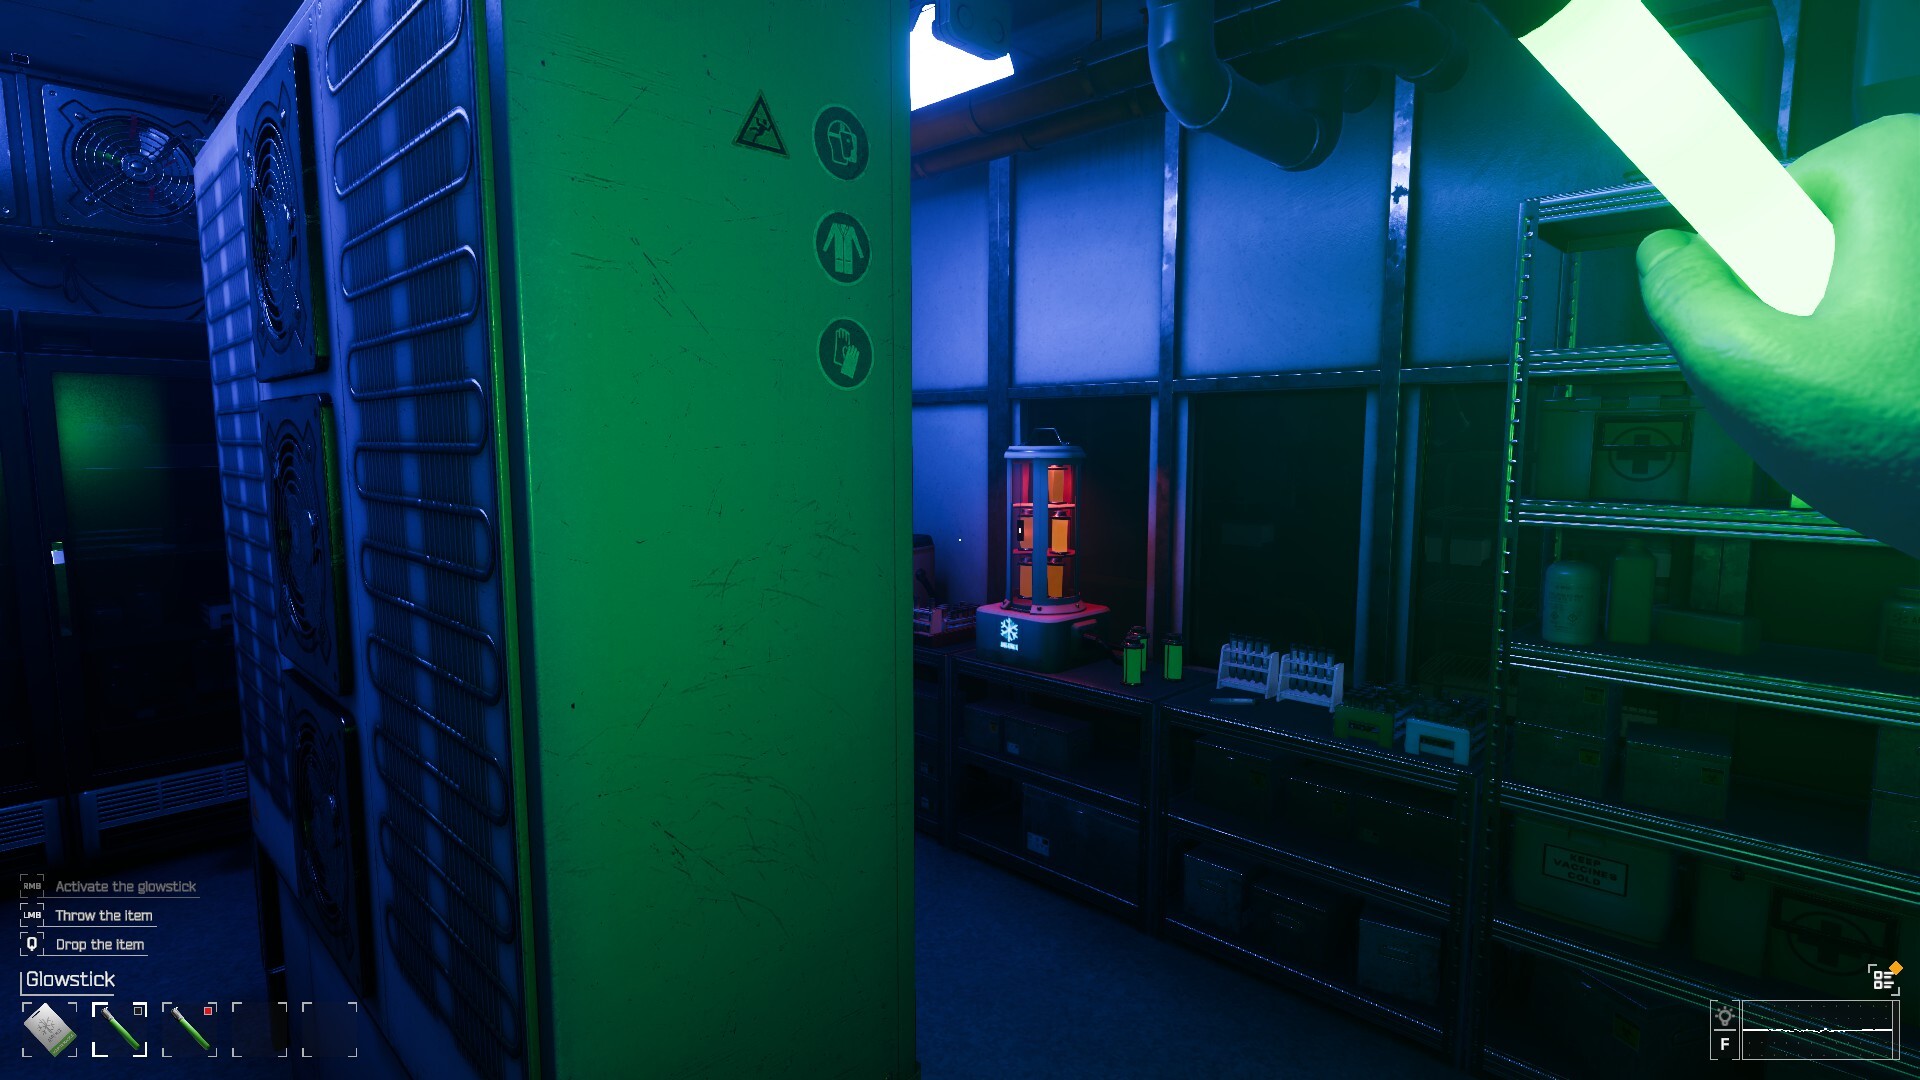
《冰封绝境》中文版 游戏介绍 CRYO 是一款支持 1–4 名玩家的多人合作生存恐怖游戏。由于通讯出现异常,你受公司派遣前往南极各地的不同设施。然而,在这些黑暗而偏远的区域等待着你的,远比一次普通的技术故障更加邪恶可怕…… 游戏截图 版本介绍 Build.25210441|容量17GB|官方简体中文|支持键盘.鼠标.手柄 **Steam 玩家评价**玩家评价统计 **特别好评 8.1/10综合评分 Steam 好评率 86.9%· 556 条评价 数据更新于 2026-09-16 整体口碑很好,值得下载体验 好评 483差评 73修正口碑 81.4% ⬇️ 下载地址 下载后请先检查文件完整性,如有问题请在评论区反馈
-
轻松玩转企业级Docker技术 1.png 课程介绍 跟着大师的脚步,轻松玩转Docker企业级部署实战。课程内容分为多个阶段,逐步渐进的帮助同学们深入学习和理解Docker技术,课程内容包括了Docker体系架构,Docker使用案例,镜像实操,Docker部署SpringBoot项目等高级内容。 学习地址 百度:https://pan.baidu.com/s/15eIG0EZL8nA2mHkhZb4GZQ 天翼:https://cloud.189.cn/t/Mj2MVrnymiQj 阿里:https://www.aliyundrive.com/s/nWMkAT156J4 下载后请先检查文件完整性,如有问题请在评论区反馈
-
千金舌诊医学系统班学习课程 1.png 课程介绍 本课程旨在教授传统中医千金舌诊技术。学员将学习舌诊的原理、历史及其在中医诊断中的重要性。课程包括舌相观察、辨舌质、辨舌苔等内容,并结合实践案例进行教学。通过本课程,学员将掌握舌诊技术并能在临床实践中应用。 学习地址 百度:https://pan.baidu.com/s/1mAw6SHj8eT-GLpyMm_yksA?pwd=k6b4 天翼:https://cloud.189.cn/t/YZfANfUraeYr(访问码:d5bi) 阿里:https://www.alipan.com/s/DEHtmYycYz2 夸克:https://pan.quark.cn/s/86f3c68dcc59 下载后请先检查文件完整性,如有问题请在评论区反馈