找到 476 篇与 网站源码 相关的结果 - 第 6 页
-
 mendmix-cloud {card-default label="? 项目信息"} ? 项目名称:mendmix-cloud ? 开发语言:Java ⭐ Star数:2732 | ? Fork数:1157 ? 开源协议:Apache-2.0 ? 项目地址:https://gitee.com/dromara/mendmix-cloud {/card-default} 项目介绍 Mendmix-cloud定位是一站式云原生架构技术底座。Mendmix-cloud提供了数据库、缓存、消息中间件、分布式定时任务、安全框架、网关以及主流产商云服务快速集成能力。基于Mendmix-cloud可以不用关注技术细节快速搭建高并发高可用基于微服务的分布式架构。 项目详情 项目截图 资源索引 快速开始 文档列表 快速上手-mendmix-tutorial 集成项目-oneplatform 简介 Mendmix定位是一站式分布式开发架构开源解决方案及云原生架构技术底座。Mendmix提供了数据库、缓存、消息中间件、分布式定时任务、安全框架、网关以及主流产商云服务快速集成能力。基于Mendmix可以不用关注技术细节快速搭建高并发高可用基于微服务的分布式架构。 发展历程jeesuite-libs→Mendmix 2015年发布第一版取名叫jeesuite-libs一直沿用至今,定位是工具型软件,以各个模块能完全独立使用为前提。经过近8年的发展以及在多家大型公司技术中台、数字化转型、企业上云过程中锤炼,定制化越来越高,jeesuite-libs从原来一个个离散的点变成了一个逻辑完备的面,也就是形成了一整套分布式架构及云原生架构的解决方案。基于这种转变jeesuite-libs不再适合我们的发展方向,因此现在更名为Mendmix。 关于Mendmix ✅寓意:Mend+Mix,解决各种框架整合、各种场景的融合的问题、形成一整套完全自洽的解决方案 ✅理念:融合、增强、包容、自洽 ✅原则:最小依赖可运行;只做增强不修改依赖框架本;贴近业务场景只做有用的功能 最小运行依赖 以下是包含了消息队列、定时任务、存储、全局锁、缓存、Mybatis增强等各种场景最小化运行依赖。如果需要支持分布式仅仅只需要增加必要的配置和第三方依赖包即可。 Spring + Springcloud必要组件 Mybatis,mybatis-spring,Druid Quartz 以及一些诸如guava,jackson的工具类库 功能图谱 模块核心功能说明其他说明mendmix-commonhttp、json、加解密、异步、GUID等工具类以及整体架构一些规范性定义 mendmix-common2分布式锁、轻量级定时任务、全局workerId生成等依赖中间件的通用组件 mendmix-springSpring工厂以及一些相关工具类、配置二次处理、一些运行机制规范定义 mendmix-cache缓存中间件适配、多redis实例快速注册及管理 mendmix-scheduler分布式定时任务,基于quartz、redis、zookeeper实现,支持日志上报、重试、多租户、并行处理,提供管理API支持redis或zookeeper分布式协调mendmix-mybatisCRUD增强、通用字段自动处理、自动缓存、读写分离、软删除、乐观锁、数据权限、安全审计兼容Mapper3增强框架mendmix-security认证和鉴权(接口权限)、session管理器、支持oauth2.0等不依赖任何第三方权限框架mendmix-logging多日志厂商适配、日志采集上报、应用日志动态刷新机制 mendmix-springweb接口规范定义,通用拦截器、mock用户、请求响应增强插件机制 mendmix-springcloud-support组件自动注册、springcloud 组件增强 mendmix-gateway认证、接口权限、审计日志、openAPI、响应统一包装、限流、防重复提交、命中缓存降级访问默认集成mendmix-security模块mendmix-amqp-adapter消息中间件适配,目前支持:内存队列、redis、kafka、rocketMQ、腾讯云及阿里云的云厂商MQ产品 mendmix-cos-adapter文件存储适配,目前支持:minIO、七牛、阿里云、腾讯云、华为云、AWS的文件存储服务 版本 sonatype https://search.maven.org/search?q=mendmix 关于作者 15年IT互联网老兵,熟悉微服务、k8s、云原生架构及各种分布式架构; DDD领域驱动早期实践者,2012-2014年作为开源项目koala企业级开发平台核心开发主推领域驱动设计理念; 荣获2021年度海纳奖—分布式数据库十大优秀实践人物 项目截图 ??知识星球?? 欢迎加入我的知识星球。提供mendmix各种问题交流,定期分享架构实践、架构案例、面试技巧等。项目截图 ⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/dromara/mendmix-cloud/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈

-
jenkins-cli {card-default label="? 项目信息"} ? 项目名称:jenkins-cli ? 开发语言:Go ⭐ Star数:541 | ? Fork数:106 ? 开源协议:MIT ? 项目地址:https://gitee.com/jenkins-zh/jenkins-cli {/card-default} 项目介绍 Jenkins CLI 可以帮忙你轻松地管理 Jenkins。不管你是一名插件开发者、管理员或者只是一个普通的 Jenkins 用户,它都是为你而生的! 项目详情 快速开始 English Jenkins CLI Gitpod ready-to-code ! ! codecov Contributors GitHub release GitHub All Releases Docker Pulls GitHub code size in bytes HitCount Jenkins CLI 可以帮忙你轻松地管理 Jenkins。不管你是一名插件开发者、管理员或者只是一个普通的 Jenkins 用户,它都是为你而生的! 特性 支持多 Jenkins 实例管理 插件管理(查看列表、搜索、安装、上传) 任务管理(搜索、构建触发、日志查看) 支持配置即管理 在浏览器中打开你的 Jenkins 重启你的 Jenkins 支持通过代理连接 安装 我们目前支持的操作系统包括:MacOS、Linux 以及 Windows。 mac 你可以通过 brew 来安装 jcli。 brew tap jenkins-zh/jcli brew install jcliLinux 要在 Linux 操作系统上安装 jcli 的话,非常简单。只需要执行下面的命令即可: curl -L https://github.com/jenkins-zh/jenkins-cli/releases/latest/download/jcli-linux-amd64.tar.gz|tar xzv sudo mv jcli /usr/local/bin/Windows 你只要点击这里就可以下载到最新版本的压缩包。之后,把解压后的文件 jcli 拷贝到你的系统目录下即可。 其他包管理器 这里还有一些其他的包管理器: Scoop 的用户可以使用命令 scoop install jcli 来安装 了解更多如何下载 jcli. 你可以从这里获取下载的统计信息。 入门 查阅官方文档可以了解到更多有关如何使用 jcli 的信息。 或者,你可以选择 Jenkins CLI 的一个在线的交互式教程。 插件 通过安装插件可以增强 Jenkins CLI 的功能。按照下面的命令就可以安装一个插件: jcli config plugin fetch jcli config plugin install account所有官方的插件,都可以在这里找到。 贡献 如果你对该项目感兴趣,请首先仔细阅读我们的贡献指南。我们欢迎任何形式的贡献。 感谢 JetBrains 为我们提供了开源许可证。 goland.svg 相关的项目 有一些相关的项目你可能会比较感兴趣: jenni 是一个 Jenkins 个人助手 点赞数趋势图 Stargazers over time ⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/jenkins-zh/jenkins-cli/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
fire {card-default label="? 项目信息"} ? 项目名称:fire ? 开发语言:Scala ⭐ Star数:727 | ? Fork数:231 ? 开源协议:Apache-2.0 ? 项目地址:https://gitee.com/fire-framework/fire {/card-default} 项目介绍 Fire框架是中通大数据自主研发并开源的大数据框架,专为Spark和Flink任务开发设计,可显著降低70%以上的代码量。该框架创新性地采用基于注解的方式进行Spark和Flink任务开发,并集成了实时血缘追踪、根因诊断、动态调优以及参数热调整等多项平台化功能。Fire框架已被数十家公司采用,累计收获了近千个Star,并拥有超过200人的社区,其中包括来自美团、阿里巴巴、作业帮等知名企业的成员。 项目详情 项目截图 项目截图 项目截图 Fire框架 Fire框架是由中通大数据自主研发并开源的、专门用于进行Spark和Flink任务开发的大数据框架,可节约70%以上的代码量。首创基于注解进行Spark和Flink任务开发,具备实时血缘、根因诊断、动态调优、参数热调整等众多平台化功能。Fire框架在中通内部每天处理数据量高达数千亿,在外部已被数十家公司所使用。 一、就这么简单! 1.1 Flink开发示例 @Config( """ |state.checkpoints.num-retained=30 # 支持任意Flink调优参数、Fire框架参数、用户自定义参数等 |state.checkpoints.dir=hdfs:///user/flink/checkpoint |""") @Hive("thrift://localhost:9083") // 配置连接到指定的hive @Streaming(interval = 100, unaligned = true) // 100s做一次checkpoint,开启非对齐checkpoint @Kafka(brokers = "localhost:9092", topics = "fire", groupId = "fire") object FlinkDemo extends FlinkStreaming { @Process def kafkaSource: Unit = { val dstream = this.fire.createKafkaDirectStream() // 使用api的方式消费kafka sql("""create table statement ...""") sql("""insert into statement ...""") } }1.2 Spark开发示例 @Config( """ |spark.shuffle.compress=true # 支持任意Spark调优参数、Fire框架参数、用户自定义参数等 |spark.ui.enabled=true |""") @Hive("thrift://localhost:9083") // 配置连接到指定的hive @Streaming(interval = 100, maxRatePerPartition = 100) // 100s一个Streaming batch,并限制消费速率 @Kafka(brokers = "localhost:9092", topics = "fire", groupId = "fire") object SparkDemo extends SparkStreaming { @Process def kafkaSource: Unit = { val dstream = this.fire.createKafkaDirectStream() // 使用api的方式消费kafka sql("""select * from xxx""").show() } }说明:structured streaming、spark core、flink sql、flink批任务均支持,代码结构与上述示例一致。 二、开发与示例 2.1 Spark开发示例 2.2 Flink开发示例 示例项目clone后导入idea即可run,无需任何额外配置! 三、亮点多多! 3.1 兼容主流版本 fire框架适配了不同的spark与flink版本,支持spark2.x及以上所有版本,flink1.10及以上所有版本,支持基于scala2.11或scala2.12进行编译。 # 可根据实际需要选择不同的引擎版本进行fire框架的构建 mvn clean install -DskipTests -Pspark-3.0 -Pflink-1.14 -Pscala-2.12Apache SparkApache Flink2.3.x1.12.x2.4.x1.13.x3.0.x1.14.x3.1.x1.15.x3.2.x1.16.x3.3.x1.17.x3.4.x1.18.x3.5.x1.19.x3.2 简单好用 Fire框架高度封装,屏蔽大量技术细节,许多connector仅需一行代码即可完成主要功能。同时Fire框架统一了spark与flink两大引擎常用的api,使用统一的代码风格即可实现spark与flink的代码开发。 HBase API // 读取HBase中指定rowkey数据并将结果集封装为DataFrame返回 val studentDF: DataFrame = this.fire.hbaseGetDF(hTableName, classOf[Student], getRDD) // 将指定数据集分布式插入到指定HBase表中 this.fire.hbasePutDF(hTableName, studentDF, classOf[Student]) JDBC API 通过注解配置数据源: @Jdbc(url = "jdbc:mysql://mysql-server:3306/fire", username = "root", password = "root") Spark示例: // 将DataFrame中指定几列插入到关系型数据库中,每100条一插入 df.jdbcBatchUpdate(insertSql, Seq("name", "age", "createTime", "length", "sex"), batch = 100) // 将查询结果通过反射映射到DataFrame中 val df: DataFrame = this.fire.jdbcQueryDF(querySql, Seq(1, 2, 3), classOf[Student]) Flink示例: val dstream = this.fire.createKafkaDirectStream().map(t => JSONUtils.parseObject[Student](t)) val sql = s""" |insert into spark_test(name, age, createTime) values(?, ?, ?) |ON DUPLICATE KEY UPDATE age=18 |""".stripMargin // sinkJdbc只需指定sql语句即可,fire会自动推断sql中占位符与JavaBean中成员变量的对应关系 dstream.sinkJdbc(sql) dstream.sinkJdbcExactlyOnce(sql, keyNum = 2)3.3 灵活的配置方式 支持基于接口、apollo、配置文件以及注解等多种方式配置,支持将spark&flink等引擎参数、fire框架参数以及用户自定义参数混合配置,支持运行时动态修改配置。几种常用配置方式如下(配置手册): 基于配置文件: 创建类名同名的properties文件进行参数配置 基于接口配置: fire框架提供了配置接口调用,通过接口获取所需的配置,可用于平台化的配置管理 基于注解配置: 通过注解的方式实现集群环境、connector、调优参数的配置,常用注解如下: @Config( """ |# 支持Flink调优参数、Fire框架参数、用户自定义参数等 |state.checkpoints.num-retained=30 |state.checkpoints.dir=hdfs:///user/flink/checkpoint |""") @Hive("thrift://localhost:9083") @Checkpoint(interval = 100, unaligned = true) @Kafka(brokers = "localhost:9092", topics = "fire", groupId = "fire") @RocketMQ(brokers = "bigdata_test", topics = "fire", groupId = "fire", tag = "*", startingOffset = "latest") @Jdbc(url = "jdbc:mysql://mysql-server:3306/fire", username = "root", password = "..root726") @HBase("localhost:2181")配置获取: Fire框架封装了统一的配置获取api,基于该api,无论是spark还是flink,无论是在Driver | JobManager端还是在Executor | TaskManager端,都可以一行代码获取所需配置。这套配置获取api,无需再在flink的map等算子中复写open方法了,用起来十分方便。 this.conf.getString("my.conf") this.conf.getInt("state.checkpoints.num-retained") ...3.4 多集群支持 Fire框架的配置支持N多集群,比如同一个任务中可以同时配置多个HBase、Kafka数据源,使用不同的数值后缀即可区分(keyNum): // 假设基于注解配置HBase多集群如下: @HBase("localhost:2181") @HBase2(cluster = "192.168.0.1:2181", storageLevel = "DISK_ONLY") // 代码中使用对应的数值后缀进行区分 this.fire.hbasePutDF(hTableName, studentDF, classOf[Student]) // 默认keyNum=1,表示使用@HBase注解配置的集群信息 this.fire.hbasePutDF(hTableName2, studentDF, classOf[Student], keyNum=2) // keyNum=2,表示使用@HBase2注解配置的集群信息3.5 常用connector支持 支持kafka、rocketmq、redis、HBase、Jdbc、clickhouse、Hive、hudi、tidb、adb等常见的connector。 3.6 checkpoint热修改 支持运行时动态调整checkpoint周期、超时时间、并行checkpoint等参数,避免任务重启时由于反压带来的checkpoint压力。 3.7 streaming热重启 该功能是主要用于Spark Streaming任务,通过热重启技术,可以在不重启Spark Streaming的前提下,实现批次时间的热修改。比如在web端将某个任务的批次时间调整为10s,会立即生效。 3.8 配置热更新 用户仅需在web页面中更新指定的配置信息,就可以让实时任务接收到最新的配置并且立即生效。最典型的应用场景是进行Spark任务的某个算子partition数调整,比如当任务处理的数据量较大时,可以通过该功能将repartition的具体分区数调大,会立即生效。 3.9 在线性能诊断 深度集成Arthas,可对运行中的任务动态进行性能诊断。fire为arthas诊断提供rest接口,可通过接口调用的方式选择为driver、jobmanager或executor、taskmanager动态开启与关闭arthas诊断线程,然后向统一的arthas tunnel服务注册,即可在网页端输入arthas命令进行性能诊断。 arthas-shell 3.10 sql在线调试 Fire框架对外暴露了restful接口,平台等系统可通过接口调用的方式将待执行的sql语句动态传递给fire,由fire将sql提交到对应的引擎,并将sql执行结果通过接口调用的方式返回,实现实时任务sql开发的在线调试,避免重复修改代码发布执行带来的时间成本。 3.11 实时血缘 Fire框架支持运行时统计分析每个任务所使用到的数据源信息、库表信息、操作类型等,并将这些血缘信息通过接口的方式对外暴露。实时平台等web系统通过接口调用的方式即可获取到实时血缘信息。截止目前,Fire框架支持高达30多种主流connector的血缘解析,包括:paimon、hudi、doris、hive、jdbc、StarRocks、HBase等等。Fire框架会将解析的血缘拼接成json格式,通过配置的地址周期性发送到指定的kafka topic中,下游实时平台消费血缘信息并做展示即可。 fire血缘架构 Fire框架同时支持**Spark**与**Flink**两大流式计算引擎的血缘解析,可实现全面洞悉数据流转链路、打通离线与实时计算的血缘形成闭环、还可协助快速定位线上的问题。 fire血缘展示 3.12 定时调度 Fire框架内部封装了quartz框架,实现通过Scheduled注解即可完成定时任务的注册。 /** * 声明了@Scheduled注解的方法是定时任务方法,会周期性执行 * * @scope 默认同时在driver端和executor端执行,如果指定了driver,则只在driver端定时执行 * @initialDelay 延迟多长时间开始执行第一次定时任务 */ @Scheduled(cron = "0/5 * * * * ?", scope = "driver", initialDelay = 60000) def loadTable: Unit = { this.logger.info("更新维表动作") }3.13 平台无缝集成 Fire框架内置restful服务,并将许多功能通过接口的方式对外暴露,实时平台可以通过fire框架暴露的接口实现与每个实时任务的信息连接。 3.14 fire-shell Fire框架整合spark shell与flink shell,支持通过REPL方式去动态调试spark和flink任务,并且支持fire框架的所有API。fire框架将shell能力通过接口方式暴露给实时平台,如此一来就可以通过web页面去调试spark和flink任务了。 四、升级日志 五、期待你的加入 社区技术交流:35373471(钉钉) 入群请备注:公司名称-岗位-昵称,否则不予理会 项目截图 项目截图 ⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/fire-framework/fire/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
kwdb {card-default label="? 项目信息"} ? 项目名称:kwdb ? 开发语言:None ⭐ Star数:1613 | ? Fork数:1240 ? 开源协议:None ? 项目地址:https://gitee.com/kwdb/kwdb {/card-default} 项目介绍 KWDB 是一款面向 【AIoT 场景】的【分布式多模数据库】,支持在同一实例同时建立时序库和关系库并融合处理多模数据,具备千万级设备接入、百万级数据秒级写入、亿级数据秒级读取等时序数据高效处理能力,具有稳定安全、高可用、易运维等特点。 项目详情 KWDB 简体中文 | English 了解 KWDB KWDB 是开放原子开源基金会孵化及运营的面向 AIoT 物联网场景的分布式多模数据库项目。基于浪潮 KaiwuDB 开源,支持在同一实例同时建立时序库和关系库并融合处理多模数据,具备千万级设备接入、百万级数据秒级写入、亿级数据秒级读取等时序数据高效处理能力,具有稳定安全、高可用、易运维等特点。典型应用场景包括但不限于物联网、能源电力、交通车联网等,旨在为各行业领域提供一站式数据存储、管理与分析的基座,助力企业数智化建设,以更低的成本挖掘更大的数据价值。 KWDB 适配多种场景,为开发者提供: 多种通用连接接口,具备高速写入、极速查询、SQL 支持、随需压缩、数据生命周期管理、集群部署等特性,与第三方工具无缝集成,降低开发及学习难度,提升开发使用效率。 快速安装部署、升级、迁移、监控等能力,提升数据库运维效率,降低数据库运维管理成本。 数据库可视化管理工具、时序数据库基准测试工具、监控指标模板等多种生态工具。 MCP Server、AI 智能助手和 AI 智能体等多种 AI 赋能工具,帮助用户更高效、更智能的开发和维护 KWDB。 关键词:物联网(IoT)、多模数据库、分布式、时序数据处理、云边端协同 快速开始 推荐使用 Docker 快速体验 KWDB: docker run -d --privileged --name kwdb \ -p 26257:26257 \ -p 8080:8080 \ -v /var/lib/kaiwudb:/kaiwudb/deploy/kaiwudb-container \ --ipc shareable \ -w /kaiwudb/bin \ kwdb/kwdb \ ./kwbase start-single-node \ --insecure \ --listen-addr=0.0.0.0:26257 \ --http-addr=0.0.0.0:8080 \ --store=/kaiwudb/deploy/kaiwudb-containerkwbase 是 KWDB 提供的内置命令行工具,用户可以通过 kwbase 连接 KaiwuDB,进行数据库操作和维护。 使用 Docker 连接 KWDB 并开启交互式 SQL Shell: docker exec -it kwdb ./kwbase sql --insecure --host=127.0.0.1编译和安装 KWDB 支持用户根据需求选择二进制安装包、容器和源码安装 KWDB 数据库: 二进制安装包:前往KaiwuDB 官网下载二进制安装包,支持单机和集群以及安全和非安全部署模式,更多信息见快速部署和集群部署。 容器镜像:KWDB 提供了多种容器镜像下载渠道,用户可以根据当前网络环境选择合适的镜像。 官方仓库:kwdb/kwdb 国内镜像:crpi-9ix5pwqh4t79xf4r.cn-shanghai.personal.cr.aliyuncs.com/kaiwudb/kwdb Github 容器镜像:ghcr.io/kwdb/kwdb 源码:源码编译目前支持单节点非安全模式部署。 以下指南以 Ubuntu 22.04 操作系统为例说明如何编译源码和安装 KWDB。 操作系统和软件依赖 KWDB 支持在 Linux 操作系统进行安装部署,下表列出了编译和运行 KWDB 所需的软件依赖。 编译依赖: 依赖版本说明ca-certificatesany Gov1.15+ CMakev3.23 Autoconfv2.68+ goyaccv0.8.0+ dpkg-devany仅适用Ubuntu系统。devscriptsany仅适用Ubuntu系统。build-essentialany checkinstallany libsslv1.1.1+- Ubuntu系统该依赖名为libssl-dev。- RHEL, CentOS, Kylin, UOS, AnolisOS系统该依赖名为libssl-devel。libprotobufv3.6.1+- Ubuntu系统该依赖名为libprotobuf-dev。- RHEL, CentOS, Kylin, UOS, AnolisOS系统该依赖名为libprotobuf-devel。liblzmav5.2.0+- Ubuntu系统该依赖名为liblzma-dev。- RHEL, CentOS, Kylin, UOS, AnolisOS系统该依赖名为liblzma-devel。libncursesv6.2.0+- Ubuntu系统该依赖名为libncurses5-dev。- RHEL, CentOS, Kylin, UOS, AnolisOS系统该依赖名为libncurses-devel。libatomicv7.3.0+仅 GCC 和 G++ 7.3.0 版本需要增加此依赖。libstdc++-staticv7.3.0+仅 GCC 和 G++ 7.3.0 版本需要增加此依赖。protobuf-compilerany gitany libprotoc-devv3.6.1+- Ubuntu系统该依赖名为libprotoc-dev。- RHEL, CentOS, Kylin, UOS, AnolisOS系统该依赖名为libprotobuf-devel。gflagsV2.2.2 libz4V1.9.2 运行依赖: 依赖版本opensslv1.1.1+libprotobufv3.6.1+ 注意:Ubuntu 18.04 默认的 libprotobuf 版本不满足要求,用户需要提前安装所需版本(推荐 3.6.1 和 3.12.4),并在编译时通过 make PROTOBUF_DIR= 指定高版本路径。geosv3.3.8+xz-libsv5.2.0+squashfs-toolsanylibgccv7.3.0+mountanysquashfuseany环境准备 下载和解压 CMake 安装包。 tar -C /usr/local/ -xvf cmake-3.23.4-linux-x86_64.tar.gz mv /usr/local/cmake-3.23.4-linux-x86_64 /usr/local/cmake 下载和解压 Go 安装包。 tar -C /usr/local -xvf go1.22.5.linux-amd64.tar.gz 创建用于存放项目代码的代码目录。 mkdir -p /home/go/src/gitee.com 设置 Go 和 CMake 的环境变量。 个人用户设置:修改~/.bashrc 文件 系统全局设置(需要 root 权限):修改/etc/profile文件 export GOROOT=/usr/local/go export GOPATH=/home/go #请以实际代码下载存放路径为准,在此以home/go目录为例 export PATH=$PATH:/usr/local/go/bin:/usr/local/cmake/bin 使变量设置立即生效: 个人用户设置: source ~/.bashrc - 系统全局设置: source /etc/profile 下载代码 在 KWDB 代码仓库下载代码,并将其存储到 GOPATH 声明的目录。 使用 git clone 命令: git clone https://gitee.com/kwdb/kwdb.git /home/go/src/gitee.com/kwbasedb #请勿修改目录路径中的 src/gitee.com/kwbasedb cd /home/go/src/gitee.com/kwbasedb git submodule update --init #适用于首次拉取代码 git submodule update --remote 下载代码压缩包,并将其解压缩到指定目录。 构建和安装 在项目目录下创建并切换到构建目录。 cd /home/go/src/gitee.com/kwbasedb mkdir build && cd build 运行 CMake 配置。 cmake .. -DCMAKE_BUILD_TYPE= [Release | Debug]参数说明: CMAKE_BUILD_TYPE:指定构建类型,默认为 Debug。可选值为 Debug 或 Release,首字母需大写。 禁用Go模块功能。 设置环境变量 个人用户设置:修改~/.bashrc 文件 系统全局设置(需要 root 权限):修改/etc/profile文件 export GO111MODULE=off 使变量设置立即生效: 个人用户设置: source ~/.bashrc 系统全局设置: source /etc/profile 编译和安装项目。 提示: 如果编译时出现遗留的 protobuf 自动生成的文件导致报错,可使用make clean 清理编译目录。 如果需要额外指定 protobuf 的文件路径,请使用 make PROTOBUF_DIR=。 make make install编译和安装成功后的文件清单如下: /home/go/src/gitee.com/kwbasedb ├── install │ ├── bin │ │ ├── err_inject.sh │ │ ├── query_kwbase_status.sh │ │ ├── query_status.sh │ │ ├── setup_cert_file.sh │ │ ├── utils.sh │ │ └── kwbase │ └── lib │ ├── libcommon.so │ └── libkwdbts2.so (可选)进入 kwbase 脚本所在目录,查看数据库版本,验证是否安装成功。 ./kwbase version KaiwuDB Version: V2.0.3.2_RC3-3-gfe5eeb853e-dirty Build Time: 2024/07/19 06:24:00 Distribution: Platform: linux amd64 (x86_64-linux-gnu) Go Version: go1.22.5 C Compiler: gcc 11.4.0 Build SHA-1: fe5eeb853e0884a963fd43b380a0b0057f88fb19启动数据库 进入 kwbase 脚本所在目录。 cd /home/go/src/gitee.com/kwbasedb/install/bin 设置共享库的搜索路径。 export LD_LIBRARY_PATH=../lib 启动数据库。 ./kwbase start-single-node --insecure --listen-addr=:26257 --background 数据库启动后即可通过 kwbase CLI 工具、KaiwuDB 开发者中心或 JDBC 等连接器连接和使用 KWDB,具体连接和使用内容见使用 kwbase CLI 工具连接 KWDB、使用 KaiwuDB 开发者中心连接 KWDB 和使用 JDBC 连接 KWDB。 社区 欢迎广大社区用户及开源爱好者 Star & Fork KWDB,并踊跃参与到我们的社区活动之中,携手共同建设社区。若需了解详情,请查阅我们的社区贡献相关内容。开发者可通过 Issue)、PR 以及技术交流群等方式展开沟通协作,助力社区实现更为良好的发展。 案例 KWDB 典型应用场景包括但不限于物联网、能源电力、交通车联网、智慧政务、IT 运维、金融证券等,更多信息请参见应用案例。 发版说明 请参见发版说明。 许可证 本项目根据 MulanPSL2 许可证授权。 声明 KWDB 是由开放原子开源基金会(OpenAtom Foundation)孵化及运营的开源项目。 项目截图 合作交流 如果你想和更多 KWDB 的用户互动交流,请扫下方二维码(备注:Gitee),KWDB 官方小助手将协助你加入官方技术交流群。 官方渠道 官网:https://www.kaiwudb.com 开源运营专区:https://kwdb.atomgit.com 公众号:KaiwuDB ⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/kwdb/kwdb/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
Adnify {card-default label="? 项目信息"} ? 项目名称:Adnify ? 开发语言:TypeScript ⭐ Star数:158 | ? Fork数:49 ? 开源协议:None ? 项目地址:https://gitee.com/adnaan/adnify {/card-default} 项目介绍 一款具备自主规划、编码调试与上线部署能力的本地 AI 智能体 IDE。像机灵的水獭?,作为你的队友全程参与项目构建。 项目详情 项目截图 Adnify 中文 | English | 日本語 | 한국어 | Español | Français | Deutsch | Português (Brasil) | Русский Connect AI to Your Code. 面向直接执行与可审查多任务编排的 AI 原生工程工作台。 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 Adnify 将代码编辑、AI 执行、素材生成和浏览器验证放进同一个桌面工作区。使用 Agent Mode 直接分析和实现,或使用 Plan Mode 澄清需求、审查任务图、按依赖执行并验收结果;跨窗口管理命令和后台服务,通过系统通知或自己的 Webhook 接收工具获取任务结果。 项目截图 ? 荣誉奖杯:鸣谢墙 "Adnify 的每一行代码,都有大家投喂的能量注入!" ⚡️感谢以下慷慨的支持者,你们提供的咖啡、奶茶和能量饮料是 Adnify 进化最强劲的动力! 排名不分先后,信息如有错误或遗漏,请及时联系作者 支持者投喂方式荣誉称号日期留言okay.? 奶茶快乐源泉注入者2026-03-07一杯快乐水,代码没 Bug!✨唐先生☕ 咖啡专注燃料赞助者2026-04-17一杯咖啡,续航下一次构建。。可乐夏日冰可乐2026-07-21一杯冰可乐,续航下一次构建。*寒☕ 咖啡咖啡动力赞助者2026-07-27一杯美式,代码写不停! ✨联系与交流 欢迎加入交流群,一起讨论 Adnify 的使用和开发! 微信群QQ 群作者微信项目截图项目截图项目截图扫码加入微信群QQ群号: 1076926858微信号: adnaan_worker? 如有问题或建议,也可以直接在 Gitee Issues 或Github Issues 提交? 查看完整更新日志 → 目录 架构设计 核心特性 素材生成 浏览器验证 执行管理 通知与后台任务 为什么选择 Adnify 快速开始 品牌素材 功能详解 快捷键 项目结构 贡献与反馈 ? 架构设计 项目截图 核心模块概览 Renderer UI src/renderer 中的 React 组件负责编辑器、Agent 交互界面、Plan 工作台、终端、本地预览以及所有面向用户的交互流程。 Agent 运行时 src/renderer/agent 为 Agent 和 Plan 任务 Worker 提供统一执行内核,覆盖模型路由、上下文流转、工具策略、权限审批、预算和异常恢复。 Plan 运行时 Plan 领域层独立管理需求、任务依赖、执行状态、产物、验收和历史记录;每个任务复用经过验证的 Agent 内核运行。 状态与会话 渲染侧 stores 管理 UI 状态、任务线程、检查点、分支和会话生命周期。独立会话存储进程持久化 SQLite 历史,冷热消息窗口限制界面加载的历史消息量。 前端服务 渲染进程中的轻量服务负责终端体验、补全、workspace/session 辅助能力, 并统一发起跨 Electron 边界的请求。 Renderer Workers 浏览器 workers 处理文本或 diff 等重计算任务, Monaco language workers 则把编辑器语言服务从 UI 线程中拆开。 Preload Bridge src/main/preload.ts 通过类型化的 contextBridge 暴露能力, 让 renderer 在不直接接触 Node 的情况下访问特权功能。 IPC Handlers src/main/ipc/*.ts 是渲染层与主进程之间的契约边界, 负责校验请求并路由到主进程能力。 共享契约 src/shared 存放跨进程复用的类型、配置、工具函数以及共享错误定义。 主进程服务 src/main 负责窗口与应用生命周期、文件系统和 shell 权限、命令调度、LLM 与 MCP 后端、LSP 管理、通知及独立服务的协调。 独立服务进程 代码索引、会话存储、素材存储和内容处理通过 Electron utility process 按需启动。同工作区的多个窗口共用索引服务,解析和 SQLite Worker 在该服务内部运行。详见进程隔离。 并发处理优势 进程隔离 renderer 专注交互与编排, main process 通过明确的 IPC 边界承载特权操作。 后台任务分工 renderer workers 承担界面侧计算,独立服务进程负责索引、数据库、嵌入计算和大文档解析,并统一管理启动、超时、退出和异常恢复。 运行安全 preload bridge、共享契约和主进程安全层共同收窄能力暴露面, 让系统边界更清晰也更易审计。 ✨ 核心特性 ? 极致视觉体验 多主题支持: 内置 4 套精心设计的主题 Adnify Dark - 默认深色主题,柔和护眼 Midnight - 深邃午夜蓝,专注编码 Cyberpunk - 霓虹赛博朋克风格 Dawn - 明亮日间主题 玻璃拟态设计: 全局采用毛玻璃风格,配合微妙的流光边框和动态阴影 沉浸式布局: 无框窗口、Chrome 风格标签页、面包屑导航 alt text alt text alt text alt text ? 两套目标明确的 AI 工作流 Adnify 只保留两种工作模式。原有独立 Chat 模式已合并进 Agent,提问、分析和实现共享同一条上下文链路,不再需要先判断“该聊天还是该执行”。 Agent Mode ? — 直接执行 在同一任务线程中完成项目问答、代码检索、文件修改、命令运行、资料查询和结果验证。 工具权限、检查点、诊断、循环检测和异常恢复,让自动执行过程始终可观察、可审批、可回退。 渐进式上下文压缩与摘要/Handoff 机制,支持持续推进长周期任务。 Plan Mode ? — 先审查,再执行 四阶段工作台覆盖 需求确认 → 计划审查 → 执行中心 → 结果验收。 Planner 生成带依赖关系、预期产物、优先级、角色/模型分配以及串并行策略的任务图。 执行前自动检查依赖环、缺失前置任务和并行写冲突。 每个任务在基于统一 Agent 内核的隔离 Worker 线程中运行;可查看实时进度、进入子任务线程、处理审批、暂停/恢复执行、要求调整并最终验收。 Plan Mode ? Agent 工具与上下文 工作区操作:在作用域授权和 Diff 预览保护下读取、新建、编辑、移动或删除文件。 代码智能:文本/正则检索、LanceDB 语义搜索,以及基于 LSP 的符号、定义、引用、悬停信息和诊断。 终端执行:前台/后台命令、实时输出、交互输入、任务停止以及可靠的退出码捕获。 研究与集成:Web 搜索、URL 读取、MCP 工具/资源/提示词和可复用 Skills。 智能上下文引用:通过文件名及 @codebase、@git、@terminal、@symbols、@web 添加上下文,也可直接拖入文件或目录。 模型自由切换:支持 OpenAI、Anthropic、Google、DeepSeek、Ollama 及 OpenAI 兼容服务,并提供推理等级和厂商参数控制。 Agent 工具 ? 素材生成与素材库 接入自己的服务:在「设置 → 扩展 → 素材能力」中连接图片、视频、音频或文件的 HTTP JSON API,可根据接口文档生成配置草稿,也支持手动编辑与 JSON 导入。 在任务中生成素材:启用后的能力可由 Agent 直接调用,按服务能力传入参考图;支持同步结果和异步任务,重启后可恢复未完成任务的状态查询。 预览和复用结果:在会话中放大图片、切换多份结果、播放视频和音频、定位文件或导出,在素材库中浏览已保存的结果与参考图历史。 控制保存位置:支持全局或项目专属输出目录,下载失败可单独重试,无需重新生成;密钥使用安全存储,配置导出不包含密钥。 配置方式与接口示例见素材能力。 ? 浏览器验证与多设备预览 直接验证前端修改:Agent 可打开开发预览或 HTTP(S) 页面,检查 DOM、样式、布局、控制台和网络诊断,并截图交给已配置的视觉模型分析。 操作真实页面:支持点击、填写表单、按键、滚动、导航和等待元素出现,将页面交互纳入验证流程。 检查响应式布局:切换桌面、手机和平板视图,支持横竖屏;切换时保留页面和表单内容,预览会自动缩放以适应面板。 项目登录态隔离:每个项目拥有独立的持久浏览器存储,同项目多窗口共享登录态,不同项目使用相同 localhost 地址也不会串用数据。 设备模拟基于 Chromium。升级到项目独立会话后,各项目预览首次使用需要重新登录。详见浏览器预览。 ⚙️ 执行管理与服务托管 跨窗口集中查看:从终端面板或「设置 → 编辑器」打开执行管理器,查看命令、后台服务、终端会话、容量占用、等待原因和退出码。 管理运行与历史:取消排队、停止作业、查看或导出日志,固定保留或删除历史归档;重启应用后仍可查看已保存的输出。 托管开发服务:可显式托管运行中的本地后台服务,关闭所有窗口后仍通过系统托盘管理。退出 Adnify 会停止托管服务,重启只恢复日志,不自动重启服务。 设置资源限额:按窗口和任务配置并发、队列,以及输出、磁盘日志和历史预算;普通命令与后台服务分别计量,历史记录不占进程名额。 回收选定的空闲会话:将本地 Agent 终端标记为可丢弃后,才允许空闲回收;人工接管、仍被占用、状态未知或有子进程的会话会保留。 ? 通知推送与后台任务 回看错过的消息:右下角常驻消息中心,分别查看编辑器提示和工作区任务事件,支持未读筛选、标记已读、查看推送状态及跳转对应任务。 选择需要关注的事件:使用「推荐提醒」「仅任务结果」或指定事件,接收完成、失败、等待输入、审批、Plan、索引和素材事件;系统通知支持仅后台窗口提醒,并可点击返回对应会话。 将结果推送到自己的工具:最多配置 5 个通用 Webhook 通道,支持事件筛选、请求头、JSON 消息模板和测试发送。推送内容为事件摘要,Webhook 配置加密保存,不随普通设置导出。 跟进长时间任务:在系统支持时显示任务栏或 Dock 进度,可选在任务执行期间防止自动休眠;唤醒后检查当前模型服务地址可达性与已有 MCP 连接状态。 定位性能问题:在「设置 → 日志与诊断」导出进程内存快照或采集 10 秒性能记录,将资源占用关联到窗口和独立服务进程。 使用说明:通知与外部推送、后台任务、性能诊断。 ? 开放的 AI 生态 Skills:从市场或 GitHub 安装,创建项目级/全局指令包,并支持自动或显式加载。 MCP:发现并安装 npm、PyPI、Docker/OCI、Cargo、NuGet、MCPB、HTTP、SSE 等类型的服务;按需支持热重载与 OAuth。 跨编辑器迁移:发现并导入 Claude Desktop/Code、Codex 和 Cursor 中兼容的 MCP、Skills 与 Rules,无需重新搭建配置。 项目记忆:通过带审批的写入路径保存项目约定与长期知识。 ? 为什么选择 Adnify 真正受控的规划流程:Plan Mode 不是更长的提示词,而是可审查的任务图、执行前确认、实时 TaskBoard 和最终结果验收。 真实的任务编排:内置依赖调度、并发上限、任务级角色/模型选择、产物契约、隔离任务线程和结果汇总。 并发修改的 worktree 隔离:可写并行任务使用独立 Git 检出与分支,通过合并队列回收结果,并提供冲突恢复操作。详见Worktree 执行车道。 面向长会话的架构:四级上下文压缩、摘要/Handoff、SQLite 任务线程持久化以及冷热消息加载共同支撑长周期工作。 可信的终端状态:OSC 633 Shell Integration 捕获命令边界和退出码,不支持原生集成时自动降级到管道 Shell 方案。 从实现到页面验证:在同一任务中生成素材、修改前端并检查或操作实时预览,覆盖手机和平板布局。 可查看和管理的后台执行:跨窗口管理命令和托管服务、保留输出日志,并通过系统通知或 Webhook 接收完成与审批提醒。 高容错代码编辑:九种匹配策略应对格式漂移,配合流式 Diff、检查点和任务线程分支,使修改可审查、可恢复。 执行后验证:Agent 可调用 LSP 诊断与项目命令验证修改,再汇报最终结果。 ? 专业代码编辑 Monaco Editor: VS Code 同款编辑器内核,完整的编辑器功能 多语言 LSP 支持: TypeScript/JavaScript、Java(需 JDK 21+)、Python、Go、Rust、C/C++、HTML/CSS/JSON、Vue、Zig、C# 等 10+ 语言 完整 LSP 功能: 智能补全、跳转定义、查找引用、悬停提示、代码诊断、格式化、重命名等 智能根目录检测: 自动识别 monorepo 子项目,为每个子项目启动独立 LSP AI 代码补全: 基于上下文的智能代码建议(Ghost Text),实时显示 AI 建议 内联编辑 (Ctrl+K): 选中代码后直接让 AI 修改,无需离开编辑器 Diff 预览: AI 修改代码前显示差异对比,支持接受/拒绝每个修改 内置调试面板: 为已支持的调试适配器提供断点、变量、调用栈、调试控制台和启动配置 text ? 强大的搜索与工具 快速打开 (Ctrl+P): 模糊搜索快速定位文件,支持路径匹配 全局搜索 (Ctrl+Shift+F): 支持正则、大小写敏感、全字匹配,实时显示结果 语义搜索: 基于 AI Embedding 的代码库语义搜索,理解代码含义 混合搜索: 结合语义搜索和关键词搜索,使用 RRF 算法融合结果 集成终端: 基于 xterm.js + node-pty,支持多 Shell(PowerShell, CMD, Bash, Zsh) 支持分屏、多标签、终端复用 Shell Integration 追踪命令边界、工作目录和退出码,并为不支持的 Shell 提供降级方案 ? 远程 SSH 终端: 内置原生 SSH 客户端,直接连接远程服务器,支持密钥认证 支持远程文件浏览、上传/下载,以及 SSH 环境中的自动 Shell Integration 本地服务预览: 从终端活动中识别开发服务器地址和候选端口 在隔离的 Webview 标签页中打开本地应用,并通过 Local Servers 面板统一管理 支持 Agent 页面检查与交互、手机和平板布局,以及按项目隔离的持久会话 Git 版本控制: 完整的 Git 操作界面,变更管理、提交历史、Diff 视图 可视化分支管理、冲突解决 支持 Git 子命令白名单,安全可控 文件管理: 虚拟化渲染支持万级文件,大型项目流畅浏览 Markdown 实时预览、图片预览 文件树拖拽、右键菜单 代码大纲: 显示文件符号结构(函数、类、变量),快速导航 问题面板: 实时诊断显示错误和警告,支持一键跳转 text ? 安全与其他特性 安全特性 工作区隔离、敏感路径保护(.ssh, .aws, .gnupg 等) 带权限审批的命令执行与 Shell 注入检测 工作区外文件需要显式授权 Webview 导航保护与最小化 Electron IPC 能力暴露 多窗口与工作区 支持多窗口同时打开不同项目 多工作区管理,快速切换工作区 工作区状态自动保存和恢复 支持 monorepo 多根工作区 其他特性 命令面板 (Ctrl+Shift+P),快速访问所有功能 SQLite 任务线程历史,支持检查点、分支、Plan 历史和异常恢复 Token 统计,实时显示消耗 完整中英文支持,自动检测系统语言 自定义快捷键,支持 VSCode 风格快捷键 引导向导,新手友好 Tree-sitter 解析 20+ 语言,精确代码分析 自动更新,静默下载新版本 ? 快速开始 环境要求 工具版本说明Node.js24.x 中的 24.19.0+(^24.19.0)仓库基线钉在 .nvmrc 和 .node-version,Node 22 与 25+ 不在支持的引擎版本范围内。pnpm11.22.0(精确)与 packageManager / engines.pnpm 完全一致,使用 corepack enable 启用 Corepack。Git较新版本即可—Python可选仅在需要从源码编译原生模块时需要package.json 的 engines 和 packageManager 声明了所需版本,preinstall(scripts/ensure-pnpm.js)会拦截其他包管理器。安装前请切换到仓库指定的 Node 版本和 pnpm 11.22.0。 开发环境运行 # 1. 克隆项目 git clone https://github.com/ad-naan/adnify.git # 或:git clone https://gitee.com/adnaan/adnify.git cd adnify # 2. 切换到仓库钉死的 Node(任选其一) # nvm use # 读取 .nvmrc # fnm use # 读取 .node-version # mise install # 读取 mise.toml # 3. 启用 Corepack,保证 pnpm 与 packageManager 一致 corepack enable # 4. 安装依赖 pnpm install # 5. 启动开发服务器 pnpm dev若出现 Electron failed to install correctly,请在 Node 24.19.0+ 下删除 node_modules/electron 后重新执行 pnpm install。 打包发布 # 1. 替换品牌资源 # 统一放在 public/brand/: # icons/ 应用图标,logos/ 应用内 Logo,ip/ IP 形象,welcome/ 欢迎/启动页素材 # 2. 构建安装包 pnpm dist # 生成的文件位于 release/ 目录? 品牌素材 Adnify 的品牌资源统一收纳在 public/brand/,README 首屏、欢迎页、应用图标与 IP 形象都从这里引用,后续替换素材时不需要在多个目录里来回找。 深色 Logo 项目截图 浅色 Logo 项目截图 应用图标 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 目录用途说明public/brand/logos/应用内 Logoapp.png 用于深色场景,app-light.png 用于浅色场景public/brand/icons/系统/平台图标Windows .ico、macOS .icns、Linux .png 与多尺寸图标输出public/brand/ip/AI 助手与 IP 形象包含优化后的 WebP 素材,可用于 README、欢迎页与聊天助手形象public/brand/welcome/欢迎页视觉dark.webp 与 light.webp 分别服务深色/浅色主题图标资源由 public/brand/logos/*.png 生成。替换 Logo 后可运行: pnpm assets:icons更多资源说明见 public/brand/README.md。 ? 功能详解 配置 AI 模型 点击左下角设置图标或按 Ctrl+, 在 Provider 选项卡选择 AI 服务商并输入 API Key 选择模型并保存 支持 OpenAI、Anthropic、Google、DeepSeek、Ollama 及自定义 API 选择工作模式 Agent Mode 是问答与实现的默认工作区。你可以询问项目情况、使用 @ 添加上下文或直接描述修改目标;Agent 会在同一任务线程中检查文件、调用工具、生成 Diff、运行验证并汇报结果。项目不再提供独立 Chat 模式。 Plan Mode 面向更复杂或风险更高的工作。当你希望在执行前确认需求、依赖关系、角色、模型、交付物和执行顺序时,应优先使用 Plan。 上下文引用:输入 @ 选择文件,或使用 @codebase、@git、@terminal、@symbols、@web 添加特殊上下文。 内联编辑:选中代码后按 Ctrl+K,无需离开编辑器即可描述修改要求。 代码库索引 打开设置 → Index 选项卡,选择 Embedding 提供商(推荐 Jina AI),配置 API Key 后开始索引。索引完成后 AI 可使用语义搜索。 使用 Plan Mode 需求确认:描述目标并回答必要的澄清问题,Adnify 会整理出包含范围与验收标准的结构化需求。 计划审查:检查任务图、依赖关系、预期产物、并发策略以及每个任务的角色/模型配置;结构检查会在执行前暴露不安全的计划。 执行中心:批准计划后,在实时 TaskBoard 中跟踪各个隔离任务线程;按需处理工具审批或暂停/恢复执行。 结果验收:检查汇总结果及失败任务状态,确认完成或要求继续调整。 ⚡ Skills 系统使用 Skills 是让 AI 获得特定领域(如特定框架优化、复杂测试编写等)专业能力的指令包。 浏览与安装: 打开设置 → Skills 选项卡。 搜索市场: 点击"搜索市场",在 skills.sh 寻找社区贡献的技能。 GitHub 安装: 输入包含 SKILL.md 的 GitHub 仓库地址直接克隆。 手动创建: 为当前项目创建专属技能,编辑生成的 SKILL.md 即可。 使用已有本地 Skill: 在设置页打开项目或全局 Skills 目录,将已有 Skill 文件夹放入后刷新 Skills 列表即可识别。 生效方式: 启用的技能会自动注入 AI 提示词(System Prompt)。 当任务触及技能相关领域时,AI 将自动遵循技能包中的专家指令。 管理: 你可以随时在设置中启用/禁用特定技能,或点击"文件夹"图标直接编辑技能源码。 可识别的本地 Skill 采用独立目录组织,目录内包含 SKILL.md,并可附带 scripts/、templates/、data/ 等辅助文件。 ⌨️ 快捷键 类别快捷键功能通用Ctrl + P快速打开文件 Ctrl + Shift + P / F1命令面板 Ctrl + ,打开设置 Ctrl + L切换 AI 面板 Ctrl + 反引号切换终端 Ctrl + Shift + D切换调试面板编辑器Ctrl + S保存文件 Ctrl + K内联 AI 编辑 Ctrl + W关闭当前文件 F12编辑器聚焦时跳转到定义搜索Ctrl + F文件内搜索 Ctrl + Shift + F全局搜索AIEnter发送指令 Shift + Enter换行 @引用上下文 /斜杠命令调试F5启动调试 F9切换断点工作模式:Agent ?(直接执行)/ Plan ?(审查与编排) ? 项目结构 adnify/ ├── resources/ # 图标资源 ├── scripts/ # 构建脚本 ├── src/ │ ├── main/ # Electron 主进程 │ │ ├── ipc/ # IPC 通信统一安全拦截层 │ │ ├── lsp/ # LSP 服务网关及生命周期治理 │ │ ├── memory/ # AI 记忆池及长期/短期上下文缓存引擎 │ │ ├── security/ # 沙盒越权拦截验证、多模态命令执行防御网 │ │ ├── indexing/ # 按工作区隔离的索引服务进程(解析、Embedding、LanceDB) │ │ └── services/ # 核心总栈子系统 │ │ ├── agent/ # 辅控层:Agent 日志分析与拦截纠错处理 │ │ ├── debugger/# Node、VSCode 协议层深度调试模块 │ │ ├── llm/ # LLM 动态桥接分发网关 (请求构造、配置解析及跨模型流式代理) │ │ ├── mcp/ # Model Context Protocol 后端服务挂载注册及鉴权授权模块 │ │ └── updater/ # 高可控自动静默静默更新探测与热切换模块 │ ├── renderer/ # 前端渲染进程 │ │ ├── agent/ # 客户端 AI 大脑核心驱动 (涵盖引擎队列、Tools执行及指令流) │ │ ├── components/ # 完全解耦聚合化复用UI组件块 │ │ │ ├── editor/ # 编辑器组件 │ │ │ ├── sidebar/ ...(内容过长,已截断,更多详情请访问项目地址) ## ⬇️ 下载地址 ## {cloud type="default" title="网盘下载" url="https://gitee.com/adnaan/adnify/repository/archive/master.zip"}
-
MilvusPlus {card-default label="? 项目信息"} ? 项目名称:MilvusPlus ? 开发语言:Java ⭐ Star数:533 | ? Fork数:132 ? 开源协议:Apache-2.0 ? 项目地址:https://gitee.com/dromara/MilvusPlus {/card-default} 项目介绍 ???使用MyBatisPlus的方式,优雅的操作向量数据库 Milvus,同时支持spring和solon 项目详情 Dromara MilvusPlus:向量数据库增强操作库 项目简介 项目截图 ???MilvusPlus(简称 MP)是一个 Milvus 的操作工具,旨在简化与 Milvus 向量数据库的交互,为开发者提供类似 MyBatis-Plus 注解和方法调用风格的直观 API,提高效率而生。特性 无侵入:只做增强不做改变,引入它不会对现有工程产生影响,如丝般顺滑 损耗小:启动即会自动注入基本 CURD,性能基本无损耗,直接面向对象操作 强大的 CRUD 操作:通用 MilvusMapper,仅仅通过少量配置即可实现 CRUD 操作,更有强大的条件构造器,满足各类使用需求 直观的 API:直接的 API 设计简化数据库操作,MilvusService 提供丰富的API。 支持 Lambda 形式调用:通过 Lambda 表达式,方便的编写各类查询条件,无需再担心字段写错 支持主键自动生成:完美解决主键问题 支持自定义全局通用操作:支持全局通用方法注入 注解式配置:采用与 MyBatis-Plus 类似的注解方式配置实体模型。 易于扩展:核心设计注重可扩展性。 类型安全:利用 Java 类型安全减少错误。 快速开始 自定义扩展支持: org.dromara.milvus-plus milvus-plus-core 2.3.0 Spring应用支持: org.dromara.milvus-plus milvus-plus-boot-starter 2.3.0 Solon应用支持: org.dromara.milvus-plus milvus-plus-solon-plugin 2.3.0 需知 2.3.0 版本升级官方 milvus-sdk-java 至 3.0.4(对齐 Milvus 3.0.x 服务端),并修复 addField / Gson / 搜索参数等已知问题 2.3.0 详细使用指南(推荐阅读) → docs/2.3.0-使用指南.md 变更清单 → CHANGELOG.md 本地 Docker → docker/README.md 2.2.0版本支持数据库版本2.5.x,增强文本搜索能力 2.1.7版本之后groupId修改为 org.dromara.milvus-plus,版本之前为 org.dromara 2.0.0版本必须使用索引注解定义索引,不然启动报错后,再添加无效,需要先删除集合 2.0.0版本暂未发布 MilvusService 功能 配置文件 milvus: uri: https://in03-a5357975ab80da7.api.gcp-us-west1.zillizcloud.com token: x'x'x'x enable: true open-log: true (默认 false 不打印) db-name: (可选) username: (可选) password: (可选) # 集合结构同步:IGNORE(默认兼容) / VALIDATE / AUTO_ADD(推荐新项目) / RECREATE(危险) schema-mode: AUTO_ADD # 仅 schema-mode=RECREATE 时生效,生产务必 false enable-recreate: false packages: - com.example.entity milvus:定义了与Milvus服务相关的配置。 uri:Milvus服务的URI,应用程序通过这个URI与Milvus服务进行通信。 token:用于验证和授权的令牌(Token),确保访问Milvus服务的安全性。 enable:一个布尔值,用于指示Milvus模块是否应该被启用。 packages:这些包包含了自定义注解对应的Java类,你可以认为这是你自定义的实体类所在的包。 schema-mode:实体注解与服务端 collection 的同步策略。 enable-recreate:是否允许 RECREATE 删表重建。 2.3.0 快速示例 // 1) 自动补齐实体新增字段 milvusService.ensureSchema(Face.class); // 2) 动态集合(分表/租户) faceMapper.forCollection("face_" + tenantId).insert(face); // 3) 语义化向量检索 faceMapper.queryWrapper() .vectorSearch(Face::getFaceVector, embedding) .eq(Face::getPersonName, "张三") .top(10) .options(opt -> opt.metricType(IndexParam.MetricType.IP)) .query(); // 4) 文本检索(BM25,无需手写 _sparse) faceMapper.queryWrapper() .textSearch(Face::getContent, "关键词") .top(10) .query(); // 5) 标量分页 faceMapper.queryWrapper().eq(Face::getStatus, 1).page(1, 20); // 6) 部分更新 faceMapper.updateWrapper().partial().updateById(face); // 7) 类 SQL WHERE(实验子集,不是完整 MySQL) faceMapper.queryWrapper() .sqlWhere("status = 1 AND name LIKE '%张%' OR type IN ('A','B')") .top(10) .query(); // 8) 原生滤器表达式(Milvus boolean expression) faceMapper.queryWrapper() .filter("status == 1 && array_contains(tags, \"vip\")") .query();本地 Docker 测试 cd docker docker compose up -d # uri: http://localhost:19530详见 docker/README.md。 应用场景 相似性搜索:快速检索与给定向量最相似的项。 推荐系统:根据用户行为和偏好推荐相关内容。 图像检索:在大规模图像库中找到与查询图像最相似的图像。 自然语言处理:将文本转换为向量并执行语义搜索。 生物信息学:分析和比较生物序列,如蛋白质和基因组数据。 自定义注解详解 使用自定义注解自动化Milvus数据库集成,提供了以下显著优势: 简化开发流程:通过注解直接在代码中声明数据库结构,不用手动创建集合、属性、索引、分区,项目启动即自动构建,减少手动编写Milvus API调用的需要。 提高开发效率:注解驱动的方式使得数据库结构的创建和管理更加快捷,加快开发速度。 增强代码可读性:将数据库结构定义与业务逻辑代码紧密结合,提高代码的可读性和可维护性。 减少错误:自动化创建数据库结构减少了人为错误的可能性,提高了系统的稳定性。 易于维护:注解的使用使得数据库结构的变更更加集中和明确,便于后期维护和升级。 @ExtraParam 注解 用途:定义索引或其他自定义功能的额外参数。 属性: key(): 参数的键名。 value(): 参数的值。 @MilvusCollection 注解 用途:定义Milvus数据库中的集合。 属性: name(): 集合的名称。 @MilvusField 注解 用途:定义Milvus集合中的字段。 属性: name(): 字段名称,默认为Java字段名。 dataType(): 数据类型,默认为FLOAT_VECTOR。 dimension(): 向量维度,默认为-1。 isPrimaryKey(): 是否为主键,默认为false。 autoID(): 是否自动生成ID,默认为false。 description(): 字段描述,默认为空。 elementType(): 元素类型,默认为None。 maxLength(): 最大长度,默认为-1。 maxCapacity(): 最大容量,默认为-1。 isPartitionKey(): 是否为分区键,默认为false。 @MilvusIndex 注解 用途:定义Milvus集合中的索引。 属性: indexType(): 索引类型,默认为FLAT。 metricType(): 度量类型,默认为L2。 indexName(): 索引名称,默认为空。 extraParams(): 额外参数,使用ExtraParam注解定义。 @MilvusPartition 注解 用途:定义Milvus集合的分区。 属性: name(): 分区的名称数组。 通过这些注解,开发者可以轻松地定义和管理Milvus数据库的结构,实现项目启动时自动构建所需数据库结构的目标。 索引与度量类型详解 索引类型(IndexType) INVALID:无效索引类型,仅用于内部标记。 FLAT:暴力搜索,适用于小规模数据集。 IVF_FLAT:倒排索引平面模式,适用于中等规模数据集。 IVF_SQ8:倒排索引量化模式,适用于大规模数据集,牺牲精度提升速度。 IVF_PQ:倒排索引产品量化模式,适用于大规模高维数据集,平衡速度和精度。 HNSW:分层导航小世界图,提供快速搜索,适用于大规模数据集。 DISKANN:基于磁盘的近似最近邻搜索,适用于存储在磁盘上的大规模数据集。 AUTOINDEX:自动选择最优索引类型。 SCANN:使用扫描和树结构加速搜索。 GPU_IVF_FLAT、GPU_IVF_PQ:GPU 加速索引,适用于 GPU 环境。 BIN_FLAT、BIN_IVF_FLAT:二进制向量专用索引。 TRIE:适用于字符串类型的字典树索引。 STL_SORT:适用于标量字段的排序索引。 度量类型(MetricType) INVALID:无效度量类型,仅用于内部标记。 L2:欧几里得距离,适用于浮点向量。 IP:内积,用于计算余弦相似度。 COSINE:余弦相似度,适用于文本和图像搜索。 HAMMING:汉明距离,适用于二进制向量。 JACCARD:杰卡德相似系数,适用于集合相似度计算。 MilvusMapper 功能 MilvusMapper 是一个用于操作 Milvus 数据库的通用接口,提供了一系列的数据操作方法,包括查询、删除、更新和插入。以下是对 MilvusMapper 及其相关类的功能描述: MilvusMapper MilvusMapper 是一个泛型抽象类,继承自 BaseMilvusMapper,提供了与 Milvus 客户端交互的基本方法。 获取 Milvus 客户端: getClient() - 返回 MilvusClientV2 实例。 BaseMilvusMapper BaseMilvusMapper 是一个抽象类,定义了与 Milvus 数据库交互的基础操作。 创建搜索构建器实例: queryWrapper() - 创建 LambdaQueryWrapper 实例。 创建删除构建器实例: deleteWrapper() - 创建 LambdaDeleteWrapper 实例。 创建更新构建器实例: updateWrapper() - 创建 LambdaUpdateWrapper 实例。 创建新增构建器实例: insertWrapper() - 创建 LambdaInsertWrapper 实例。 数据操作 通过 ID 获取数据getById(Serializable ... ids) 功能:根据提供的ID列表查询数据。 `参数`:`ids` - 一个可序列化的ID列表。 `返回`:`MilvusResp>>` - 包含查询结果的响应。 删除数据removeById(Serializable ... ids) 功能:根据提供的ID列表删除数据。 `参数`:`ids` - 一个可序列化的ID列表。 `返回`:`MilvusResp` - 删除操作的响应。 更新数据updateById(T ... entity) 功能:根据提供的实体更新数据。 `参数`:`entity` - 一个实体对象列表。 `返回`:`MilvusResp` - 更新操作的响应。 插入数据insert(T ... entity) `功能`:插入提供的实体到数据库。 `参数`:`entity` - 一个实体对象列表。 `返回`:`MilvusResp` - 插入操作的响应。 构建器方法 创建通用构建器实例: lambda(Wrapper wrapper) - 初始化并返回构建器实例。 LambdaQueryWrapper 类功能文档 LambdaQueryWrapper 是一个用于构建和执行 Milvus 搜索查询的构建器类。它提供了一系列方法来设置查询参数,并最终执行查询。 构造函数 LambdaQueryWrapper(): 无参构造函数。 LambdaQueryWrapper(String collectionName, MilvusClientV2 client, ConversionCache conversionCache, Class entityType): 构造函数,初始化集合名称、Milvus 客户端、类型转换缓存和实体类型。 分区设置 partition(String ... partitionName): 添加一个或多个分区名称到查询中。 partition(FieldFunction... partitionName): 根据提供的字段函数添加分区名称。 搜索参数设置 searchParams(Map searchParams): 设置搜索参数。 以下是 searchParams 支持的参数及其说明: metric_type 类型:String 描述:指定搜索操作使用的度量类型。必须与索引向量字段时使用的度量类型一致。 可选值: L2:欧几里得距离,适用于高维空间的向量搜索。 IP:内积,适用于余弦相似度搜索。 COSINE:余弦相似度,与内积相同,适用于测量向量间的夹角。 示例: searchParams.put("metric_type", "L2"); radius 类型:float 描述:设置搜索操作的最小相似度阈值。当 metric_type 设置为 L2 时,此值应大于 range_filter;否则,应小于 range_filter。 示例: searchParams.put("radius", 0.5f); range_filter 类型:float 描述:限定搜索操作的相似度范围。当 metric_type 设置为 IP 或 COSINE 时,此值应大于 radius;否则,应小于 radius。 示例: searchParams.put("range_filter", 0.3f); 使用示例 以下是一个使用 searchParams 的示例,展示如何构建搜索请求并设置特定的搜索参数: Map searchParams = new HashMap<>(); searchParams.put("metric_type", "L2"); searchParams.put("radius", 0.5f); searchParams.put("range_filter", 0.3f); radius(Object radius): 设置搜索半径。 rangeFilter(Object rangeFilter): 设置范围过滤器。 metricType(Object metric_type): 设置度量类型。 结果设置 outputFields(List outputFields): 设置要返回的字段。 roundDecimal(int roundDecimal): 设置返回的距离值的小数位数。 查询条件构建 eq(String fieldName, Object value): 添加等于条件。 ne(String fieldName, Object value): 添加不等于条件。 gt(String fieldName, Object value): 添加大于条件。 ge(String fieldName, Object value): 添加大于等于条件。 lt(String fieldName, Object value): 添加小于条件。 le(String fieldName, Object value): 添加小于等于条件。 between(String fieldName, Object start, Object end): 添加范围条件。 isNull(String fieldName): 添加空值检查条件。 isNotNull(String fieldName): 添加非空值检查条件。 in(String fieldName, List values): 添加 IN 条件。 like(String fieldName, String value): 添加 LIKE 条件。 JSON 和数组操作 jsonContains(String fieldName, Object value): 添加 JSON 包含条件。 jsonContainsAll(String fieldName, List values): 添加 JSON 包含所有值的条件。 jsonContainsAny(String fieldName, List values): 添加 JSON 包含任意值的条件。 arrayContains(String fieldName, Object value): 添加数组包含条件。 arrayContainsAll(String fieldName, List values): 添加数组包含所有值的条件。 arrayContainsAny(String fieldName, List values): 添加数组包含任意值的条件。 arrayLength(String fieldName, int length): 添加数组长度条件。 逻辑操作 and(ConditionBuilder other): 添加 AND 条件。 or(ConditionBuilder other): 添加 OR 条件。 not(): 添加 NOT 条件。 向量搜索设置 annsField(String annsField): 设置要搜索的向量字段。 vector(List vector): 添加要搜索的向量。 vector(String annsField, List vector): 设置向量字段并添加要搜索的向量。 topK(Integer topK): 设置返回的 top-k 结果。 limit(Long limit): 设置查询结果的数量限制。 执行查询 query(): 构建并执行搜索请求,返回封装的 MilvusResp 对象,其中包含查询结果。 query(FieldFunction ... outputFields): 设置输出字段并执行查询。 query(String ... outputFields): 设置输出字段并执行查询。 getById(Serializable ... ids): 通过 ID 获取数据。 辅助方法 buildSearch(): 构建完整的搜索请求对象。 buildQuery(): 构建查询请求对象。 LambdaQueryWrapper 类提供了丰富的方法来构建复杂的搜索查询,支持各种条件、逻辑操作、JSON 和数组操作,以及向量搜索。通过链式调用这些方法,用户可以灵活地构造搜索请求并获取所需的查询结果。 LambdaDeleteWrapper LambdaDeleteWrapper 是一个构建器类,用于构建和执行删除操作。 添加分区: partition(String partitionName) 添加等于条件: eq(String fieldName, Object value) 添加不等于条件: ne(String fieldName, Object value) 添加 ID 到删除列表: id(Object id) 执行删除 执行删除: remove() - 构建并执行删除请求。 通过 ID 删除: removeById(Serializable ... ids) LambdaUpdateWrapper LambdaUpdateWrapper 是一个构建器类,用于构建和执行更新操作。 添加分区: partition(String partitionName) 设置更新条件: 与 LambdaDeleteWrapper 相同 执行更新 更新数据: update(T t) - 构建并执行更新请求。 通过 ID 更新: updateById(T ... t) LambdaInsertWrapper LambdaInsertWrapper 是一个构建器类,用于构建和执行插入操作。 添加分区: partition(String partitionName) 添加字段值: put(String fieldName, Object value) 执行插入 插入数据: insert() - 构建并执行插入请求。 插入多个数据: insert(T ... t) MilvusService 功能 MilvusService 是一个综合性服务,提供对 Milvus 数据库的全面管理,它实现了多个接口:IAMService(身份访问管理服务)、ICMService(集合管理服务)和 IVecMService(向量管理服务)。 身份访问管理 (IAMService) IAMService 接口提供用户和角色的创建、删除、查询以及权限的授予和撤销等功能。 创建角色: createRole(String roleName) 创建用户: createUser(String userName, String password) 查询角色权限: describeRole(String roleName) 查询用户信息: describeUser(String userName) 删除角色: dropRole(String roleName) 删除用户: dropUser(String userName) 授予角色权限: grantPrivilege(String roleName, String objectType, String privilege, String objectName) 授予用户角色: grantRole(String roleName, String userName) 列出所有角色: listRoles() 列出所有用户: listUsers() 撤销角色权限: revokePrivilege(String roleName, String objectType, String privilege, String objectName, String databaseName) 撤销用户角色: revokeRole(String roleName, String userName) 更新用户密码: updatePassword(String userName, String password, String newPassword) 集合管理 (ICMService) ICMService 接口提供集合的创建、删除、查询、重命名、索引创建和管理等功能。 创建集合: createCollection(MilvusEntity milvusEntity) 添加字段: addField(String collectionName, AddFieldReq ... addFieldReq) 获取字段: getField(String collectionName, String fieldName) 获取集合详细信息: describeCollection(String collectionName) 删除集合: dropCollection(String collectionName) 检查集合是否存在: hasCollection(String collectionName) 获取集合统计信息: getCollectionStats(String collectionName) 重命名集合: renameCollection(String oldCollectionName, String newCollectionName) 为集合创建索引: createIndex(String collectionName, List indexParams) 获取集合索引信息: describeIndex(String collectionName, String fieldName) 删除集合索引: dropIndex(String collectionName, String fieldName) 获取集合或分区的加载状态: getLoadState(String collectionName, String partitionName) 加载集合数据到内存: loadCollection(String collectionName) 从内存中释放集合数据: releaseCollection(String collectionName) 创建集合分区: createPartition(String collectionName, String partitionName) 删除集合分区: dropPartition(String collectionName, String partitionName) 检查分区是否存在: hasPartition(String collectionName, String partitionName) 列出集合中的所有分区: listPartitions(String collectionName) 加载集合分区到内存: loadPartitions(String collectionName, List partitionNames) 从内存中释放集合分区: releasePartitions(String collectionName, List partitionNames) 向量管理 (IVecMService) IVecMService 接口提供向量的插入、更新、查询、删除以及相似性搜索等功能。 删除实体: delete(String collectionName, String partitionName, String filter, List ids) 根据ID获取实体: get(String collectionName, String partitionName, List ids, List outputFields) 插入数据: insert(String collectionName, List data, String partitionName) 根据标量过滤条件查询: query(String collectionName, List partitionNames, List outputFields, List ids, String filter, ConsistencyLevel consistencyLevel, long offset, long limit) 执行向量相似性搜索: search(String collectionName, List partitionNames, String annsField, int topK, String filter, List outputFields, List data, long offset, long limit, int roundDecimal, Map searchParams, long guaranteeTimestamp, long gracefulTime, ConsistencyLevel consistencyLevel, boolean ignoreGrowing) 插入或更新数据: upsert(String collectionName, String partitionName, List data) 公共方法 除了上述功能,MilvusService 还提供了一个公共方法来获取 MilvusClientV2 实例: 获取 Milvus 客户端: `getClient() 使用案例 以下是使用 MilvusPlus 进行向量搜索的示例: @Data @MilvusCollection(name = "face_collection") // 指定Milvus集合的名称 public class Face { @MilvusField( name = "person_id", // 字段名称 dataType = DataType.Int64, // 数据类型为64位整数 isPrimaryKey = true, // 标记为主键 ) private Long personId; // 人员的唯一标识符 @MilvusField( name = "face_vector", // 字段名称 dataType = DataType.FloatVector, // 数据类型为浮点型向量 dimension = 128, // 向量维度,假设人脸特征向量的维度是128 ) @MilvusIndex( indexType = IndexParam.IndexType.IVF_FLAT, // 使用IVF_FLAT索引类型 metricType = IndexParam.MetricType.L2, // 使用L2距离度量类型 indexName = "face_index", // 索引名称 extraParams = { // 指定额外的索引参数 @ExtraParam(key = "nlist", value = "100") // 例如,IVF的nlist参数 } ) private List faceVector; // 存储人脸特征的向量 } @Component public class FaceMilvusMapper extends MilvusMapper { } @Component @Slf4j public class ApplicationRunnerTest implements ApplicationRunner { private final FaceMilvusMapper mapper; public ApplicationRunnerTest(FaceMilvusMapper mapper) { this.mapper = mapper; } @Override public void run(ApplicationArguments args){ Face f ...(内容过长,已截断,更多详情请访问项目地址) ## ⬇️ 下载地址 ## {cloud type="default" title="网盘下载" url="https://gitee.com/dromara/MilvusPlus/repository/archive/master.zip"}
-
hippo4j {card-default label="? 项目信息"} ? 项目名称:hippo4j ? 开发语言:Java ⭐ Star数:1909 | ? Fork数:615 ? 开源协议:Apache-2.0 ? 项目地址:https://gitee.com/opengoofy/hippo4j {/card-default} 项目介绍 ? 异步线程池框架,支持线程池动态变更&监控&报警,无需修改代码轻松引入。 项目详情 动态可观测线程池,提高系统运行保障能力 License Build Status ! ! ! star Docker Pulls codecov EN doc ? 新项目 Ragent AI(点击跳转) —— 企业级 Agentic RAG 项目,拿个 offer 社群在 AI 领域的首个开源作品。架构设计、代码实现保持一贯的高标准,适合写进校招/社招简历。毕竟现在哪家公司不关注 AI? 线程池痛点 线程池是一种基于池化思想管理线程的工具,使用线程池可以减少创建销毁线程的开销,避免线程过多导致系统资源耗尽。在高并发以及大批量的任务处理场景,线程池的使用是必不可少的。 如果有在项目中实际使用线程池,相信你可能会遇到以下痛点: 线程池随便定义,线程资源过多,造成服务器高负载。 线程池参数不易评估,随着业务的并发提升,业务面临出现故障的风险。 线程池任务执行时间超过平均执行周期,开发人员无法感知。 线程池任务堆积,触发拒绝策略,影响既有业务正常运行。 当业务出现超时、熔断等问题时,因为没有监控,无法确定是不是线程池引起。 原生线程池不支持运行时变量的传递,比如 MDC 上下文遇到线程池就 GG。 无法执行优雅关闭,当项目关闭时,大量正在运行的线程池任务被丢弃。 线程池运行中,任务执行停止,怀疑发生死锁或执行耗时操作,但是无从下手。 什么是 Hippo4j 提供以下功能支持: 全局管控 - 管理应用线程池实例。 动态变更 - 应用运行时动态变更线程池参数,包括但不限于:核心、最大线程数、阻塞队列容量、拒绝策略等。 通知报警 - 内置四种报警通知策略,线程池活跃度、容量水位、拒绝策略以及任务执行时间超长。 数据采集 - 支持多种方式采集线程池数据,包括但不限于:日志、内置采集、Prometheus、InfluxDB、ElasticSearch 等。 运行监控 - 实时查看线程池运行时数据,自定义时间内线程池运行数据图表展示。 功能扩展 - 支持线程池任务传递上下文;项目关闭时,支持等待线程池在指定时间内完成任务。 多种模式 - 内置两种使用模式:依赖配置中心 和 无中间件依赖。 容器管理 - Tomcat、Jetty、Undertow 容器线程池运行时查看和线程数变更。 框架适配 - Dubbo、Hystrix、RabbitMQ、RocketMQ 等消费线程池运行时数据查看和线程数变更。 变更审核 - 提供多种用户角色,普通用户变更线程池参数需要 Admin 用户审核方可生效。 动态化插件 - 内置多种线程池插件,支持用户自定义插件以及运行时扩展。 多版本适配 - 经过实际测试,已支持客户端 SpringBoot 1.5.x => 2.7.5 版本(更高版本未测试)。 架构设计 项目截图 快速开始 对于本地演示目的,请参阅 Quick start 演示环境: http://console.hippo4j.cn/index.html 接入登记 更多接入的公司,欢迎在 登记地址 登记,登记仅仅为了产品推广。 联系我 开源不易,右上角点个 Star 鼓励一下吧! 如果大家想要实时关注 Hippo4j 更新的文章以及分享的干货的话,可以关注我的公众号。 使用过程中有任何问题,或者对项目有什么建议,关注公众号回复:加群,和 1000+ 志同道合的朋友交流讨论。 项目截图 深入原理 如果您公司没有使用 Hippo4j 场景的话,我也建议去阅读下项目的底层原理,主要有以下几个原因: 为了提高代码质量以及后续的扩展行为,运用多种设计模式实现高内聚、低耦合。 框架底层依赖 Spring 框架运行,并在源码中大量使用 Spring 相关功能。 运用 JUC 并发包下多种工具保障多线程运行安全,通过实际场景理解并发编程。 借鉴主流开源框架 Nacos、Eureka 实现轻量级配置中心和注册中心功能。 自定义 RPC 框架实现,封装 Netty 完成客户端/服务端网络通信优化。 通过 CheckStyle、Spotless 等插件规范代码编写,保障高质量代码行为和代码样式。 友情链接 [[ Sa-Token ]](https://github.com/dromara/sa-token):一个轻量级 java 权限认证框架,让鉴权变得简单、优雅! [[ HertzBeat ]](https://github.com/dromara/hertzbeat):易用友好的云监控系统, 无需 Agent, 强大自定义监控能力。 [[ JavaGuide ]](https://github.com/Snailclimb/JavaGuide):一份涵盖大部分 Java 程序员所需要掌握的核心知识。 [[ toBeBetterJavaer ]](https://github.com/itwanger/toBeBetterJavaer):一份通俗易懂、风趣幽默的 Java 学习指南。 [[ Jpom ]](https://gitee.com/dromara/Jpom):简而轻的低侵入式在线构建、自动部署、日常运维、项目监控软件。 [[ 12306 ]](https://gitee.com/nageoffer/12306):完成高仿 12306 用户+抢票+订单+支付服务,帮助学生主打就业的项目。 [[ CongoMall ]](https://gitee.com/nageoffer/congomall):企业级商城,基于 DDD 领域驱动模型开发,包含商城业务和基础架构。 贡献者 感谢所有为项目作出贡献的开发者。如果有意贡献,参考 good first issue。 鸣谢 Hippo4j 社区收到 Jetbrains 多份 Licenses,并已分配项目 活跃开发者,非常感谢 Jetbrains 对开源社区的支持。 JetBrains Logo (Main) logo ⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/opengoofy/hippo4j/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
hertzbeat {card-default label="? 项目信息"} ? 项目名称:hertzbeat ? 开发语言:Java ⭐ Star数:3366 | ? Fork数:1008 ? 开源协议:Apache-2.0 ? 项目地址:https://gitee.com/hertzbeat/hertzbeat {/card-default} 项目介绍 Apache HertzBeat™ 是 AI 驱动的下一代开源实时观测系统。指标日志统一收集,告警一站分发,智能管控分析。无需 Agent,高性能集群,提供强大的自定义监控和状态页构建能力。 项目详情 项目截图 Readme: English | 中文 | 日本語 Discord Reddit Twitter OpenSSF Best Practices codecov Docker Pulls Artifact Hub YouTube Channel Subscribers Contribute with Gitpod 官网: hertzbeat.apache.org 邮件: 发送至 dev-subscribe@hertzbeat.apache.org 订阅邮件列表 ? 介绍 Apache HertzBeat™ 是 AI 驱动的下一代开源实时观测系统。指标日志统一收集,告警一站分发,智能管控分析。无需 Agent,高性能集群,提供强大的自定义监控和状态页构建能力。 特点 集采集+分析+告警+通知为一体,HertzBeat AI 驱动下的新交互与功能,也内置 MCP Server 对外能力。 统一的指标平台,无需 Agent,兼容 Prometheus,支持应用服务,程序,数据库,缓存,操作系统,大数据,中间件,Web 服务器,云原生,网络,自定义等。 统一的日志平台,通过 OTLP 协议多日志源无缝对接上报。 统一的告警平台,内部告警与外部多种告警源集成接入,统一告警处理分析,灵活的实时与周期阈值规则,分组收敛,静默,抑制等。 统一的消息分发,告警平台处理后通过 邮件 Discord Slack Telegram 钉钉 微信 飞书 短信 Webhook Server酱 等方式分发通知。 将 Http, Jmx, Ssh, Snmp, Jdbc, Prometheus 等协议规范可配置化,只需配置模板 YML 就能自定义采集指标。您相信只需简单配置即可快速适配一款 K8s 或 Docker 等新的监控类型吗? 高性能,支持多采集器集群横向扩展,支持多隔离网络监控,云边协同。 提供强大的状态页构建能力,轻松向用户传达您产品服务的实时状态。 HertzBeat的统一平台,AI智能,强大自定义,多类型支持,高性能,易扩展,希望能帮助用户快速方便实现观测需求。? 模块 hertzBeat ⛄ 已支持 我们将监控采集类型(mysql,jvm,k8s)都定义为 yml 模板,用户可以导入这些模板来支持对应类型的监控! 欢迎大家一起贡献你使用过程中自定义的通用指标模板。 Website, Port Telnet, Http Api, Ping Connect, Jvm, SiteMap, Ssl Certificate, SpringBoot2, FTP Server, SpringBoot3, Udp Port, Dns, Pop3, Ntp, Api Code, Smtp, Nginx Mysql, PostgreSQL, MariaDB, Redis, ElasticSearch, SqlServer, Oracle, MongoDB, DM, OpenGauss, ClickHouse, IoTDB, Redis Cluster, Redis Sentinel Doris BE, Doris FE, Memcached, NebulaGraph Linux, Ubuntu, CentOS, Windows, EulerOS, Fedora CoreOS, OpenSUSE, Rocky Linux, Red Hat, FreeBSD, AlmaLinux, Debian Linux Tomcat, Nacos, Zookeeper, RabbitMQ, Flink, Kafka, ShenYu, DynamicTp, Jetty, ActiveMQ, Spring Gateway, EMQX MQTT, AirFlow, Hive, Spark, Hadoop Kubernetes, Docker CiscoSwitch, HpeSwitch, HuaweiSwitch, TpLinkSwitch, H3cSwitch 和更多自定义指标模板。 通知支持 Discord Slack Telegram 邮件 钉钉 微信 飞书 短信 Webhook Server酱。 ? 快速开始 如果您是想将 HertzBeat 部署到内网环境搭建监控系统,请参考下面的部署文档进行操作。 ? HertzBeat 安装 HertzBeat 支持通过源码安装启动,Docker 容器运行和安装包方式安装部署,CPU 架构支持 x86/arm64。方式一:Docker 方式快速安装 docker 环境仅需一条命令即可开始 docker run -d -p 1157:1157 -p 1158:1158 --name hertzbeat apache/hertzbeat 浏览器访问 http://localhost:1157 即可开始,默认账号密码 admin/hertzbeat 部署采集器集群(可选) docker run -d -e IDENTITY=custom-collector-name -e MANAGER_HOST=127.0.0.1 -e MANAGER_PORT=1158 --name hertzbeat-collector apache/hertzbeat-collector -e IDENTITY=custom-collector-name : 配置此采集器的唯一性标识符名称,多个采集器名称不能相同,建议自定义英文名称。 - `-e MODE=public` : 配置运行模式(public or private), 公共集群模式或私有云边模式。 - `-e MANAGER_HOST=127.0.0.1` : 配置连接主 HertzBeat 服务的对外 IP。 - `-e MANAGER_PORT=1158` : 配置连接主 HertzBeat 服务的对外端口,默认1158。 更多配置详细步骤参考 通过 Docker 方式安装 HertzBeat 方式二:通过安装包安装 下载您系统环境对应的安装包 hertzbeat-xx.tar.gz Download 配置 HertzBeat 的配置文件 hertzbeat/config/application.yml (可选) 部署启动 $ ./bin/startup.sh 或 bin/startup.bat 浏览器访问 http://localhost:1157 即可开始,默认账号密码 admin/hertzbeat 部署采集器集群(可选) 下载采集器安装包 hertzbeat-collector-xx.tar.gz 到规划的另一台部署主机上 Download 配置采集器的配置文件 hertzbeat-collector/config/application.yml 里面的连接主 HertzBeat 服务的对外 IP,端口,当前采集器名称(需保证唯一性)等参数 identity mode (public or private) manager-host manager-port collector: dispatch: entrance: netty: enabled: true identity: ${IDENTITY:} mode: ${MODE:public} manager-host: ${MANAGER_HOST:127.0.0.1} manager-port: ${MANAGER_PORT:1158} 启动 $ ./bin/startup.sh 或 bin/startup.bat 浏览器访问主 HertzBeat 服务 http://localhost:1157 查看概览页面即可看到注册上来的新采集器 更多配置详细步骤参考 通过安装包安装HertzBeat 方式三:本地代码启动 此为前后端分离项目,本地代码调试需要分别启动后端工程 hertzbeat-startup 和前端工程 web-app 后端:需要 maven3+, java17 和 lombok 环境,修改 YML 配置信息,添加JVM参数--add-opens=java.base/java.nio=org.apache.arrow.memory.core,ALL-UNNAMED后启动 hertzbeat-startup 服务即可。 前端:需要 nodejs npm angular-cli环境,待本地后端启动后,在 web-app 目录下启动 ng serve --open 浏览器访问 http://localhost:4200 即可开始,默认账号密码 admin/hertzbeat 详细步骤参考 参与贡献之本地代码启动 方式四:Docker-Compose 统一安装 hertzbeat+postgresql+tsdb 通过 Docker-Compose 部署脚本 一次性把 postgresql/mysql 数据库, victoria-metrics/iotdb/tdengine 时序数据库和 hertzbeat 安装部署。 详细步骤参考 通过 Docker-Compose 安装 HertzBeat 方式五:Kubernetes Helm Charts 部署 hertzbeat+collector+postgresql+tsdb 通过 Helm Chart 一次性将 HertzBeat 集群组件部署到 Kubernetes 集群中。 详细步骤参考 Artifact Hub HAVE FUN ✨ Contributors Thanks these wonderful people, welcome to join us: 贡献者指南 项目截图tomsun28? ? ? 项目截图会编程的王学长? ? ?  ⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/hertzbeat/hertzbeat/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
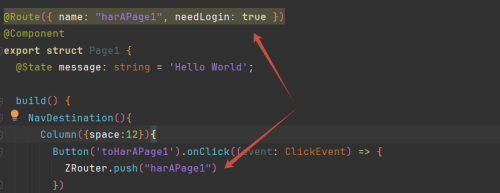
ZRouter {card-default label="? 项目信息"} ? 项目名称:ZRouter ? 开发语言:TypeScript ⭐ Star数:186 | ? Fork数:35 ? 开源协议:Apache-2.0 ? 项目地址:https://gitee.com/common-apps/ZRouter {/card-default} 项目介绍 ZRouter是一款轻量级且非侵入性的鸿蒙动态路由框架,可解决HAR/HSP业务模块间的耦合与通信问题,提供了自定义拦截器、服务路由、转场动画、生命周期函数管理、NavDestination模板化等功能。 项目详情 介绍 ZRouter是一款轻量级且非侵入性的鸿蒙动态路由框架,可解决HAR/HSP业务模块间的耦合与通信问题。主要特性: 简化Navigation使用,无需关注路由表的配置,对Navigation及NavDestination组件保持零侵入; 支持API链式调用,让API更简洁直观; 为了进一步简化使用,支持NavDestination页面模板化,是一个可选项; 注解参数支持使用静态常量,可跨模块定义; 支持自定义拦截器,可实现页面重定向、登录验证、数据预取、埋点等业务场景。 支持服务路由,可实现Har/Hsp模块间的通信; 支持全局及单个页面的生命周期函数管理,可使任意类都能享有与组件相同的生命周期特性,可用于页面埋点统计等业务场景; 支持跨多级页面参数携带返回监听; 支持自定义URL路径跳转,可在拦截器内自行解析URL实现业务逻辑; 内置多种转场动画效果(平移、旋转、渐变、缩放、高斯模糊、共享一镜到底动画),并支持自定义动画; 支持启动模式、混淆、嵌套Navigation、Hap、元服务; 支持与您现有项目中的Navigation无缝融合,实现零成本向本库迁移; 支持ArkUI-X跨平台上使用; 支持第三方应用Navigation的使用本库API; 使用十分简单,没有繁琐的配置,两行代码就可以完成页面的跳转,如下: WX20250805 102507 ZRouter已上架录入到华为鸿蒙生态伙伴组件专区 使用收集 为了持续优化鸿蒙ZRouter路由库,恳请您花一点时间填写下应用名称。您的每一次反馈,都是我们持续改进的重要动力。 https://wj.qq.com/s2/25201566/76c1/ 快速入门 ZRouter快速入门 router-register-plugin编译插件 — 很重要 下载安装 在项目根目录的hvigor目录下的hvigor-config.json5文件中配置安装 pEovcrt.png "dependencies": { "router-register-plugin":"x.x.x" },编译插件最新版本: Static Badge npm 最后记得Sync Now或重新build让插件安装生效。 或者使用hvigorw命令行工具执行任一命令,命令行工具会自动执行安装构建依赖。 hvigorw --sync配置 支持两种配置方式: 工程级配置: 即在工程根目录下的hvigorfile.ts文件中全局配置; 模块级配置:即在每个模块目录下的hvigorfile.ts文件中单独配置; 不建议一个项目同时使用两种配置方式,虽然是这种混合方式也是支持的,但容易出现配置冲突。模块级配置相对繁琐些,但配置项会更精细化些。步骤: // 1、导入 import { routerRegisterPlugin, OptionalPluginConfig } from 'router-register-plugin' // 2、初始化配置 const config: OptionalPluginConfig = { scanDirs: ['src/main/ets/pages', 'src/main/ets/views'], // 扫描的目录,如果不设置,默认是扫描src/main/ets目录 logEnabled: true, // 查看日志 viewNodeInfo: false, // 查看节点信息 ignoredModules:['RouterApi','common','xxx'], // 忽略的参与构建的模块,根据自己项目自行设置 enableUiPreviewBuild: false, // 启用UI预览构建,不建议启动 } export default { // 3、添加插件 plugins:[routerRegisterPlugin(config)] } 注意:hvigorfile.ts文件中默认配置不要删除了。配置参数说明: 参数名类型默认值描述scanDirsstring[]['src/main/ets']扫描的目录,如果不设置,默认是扫描src/main/ets目录。建议配置该字段,避免扫描所有目录,影响工程编译效率** logEnabledbooleantrue是否打印日志 viewNodeInfobooleanfalse查看节点信息,只有与logEnable同时为true才会打印输出isAutoDeleteHistoryFilesbooleanfalse是否在构建时删除编译产物,已弃用,在项目clean自动删除无用编译产物,请不要设置此参数。 lifecycleObserverAttributeNamestringlifecycleObserver如果使用了NavDest页面模板化功能,该配置字段会生效,默认属性名是lifecycleObserver,也可以在@Route注解上单独设置这个属性ignoredModulesstring[][]忽略需要扫描的模块,填写模块名称,默认是全部模块;插件在工程级时使用,该字段才会生效。建议配置该字段,避免扫描所有模块,影响工程编译效率enableUiPreviewBuildbooleanfalse是否在ui预览构建时生成,默认不启用, 会降低ui预览构建效率注意: 以上配置参数都是可选的,建议配置scanDirs和ignoredModules字段,避免扫描所有目录和模块,影响工程编译效率。编译阶段会自动生成一些文件,建议在git的.gitignore忽略掉这些文件。 _generated **/route_map.json **/router_map.jsonZRouter的基本使用 下载安装 在每个har/hsp模块中,通过ohpm工具下载安装库: ohpm install @hzw/zrouter页面跳转 新建三个模块分别是harA、harB、hspC,三者之间没有依赖关系,entry模块依赖了这三个模块,通过ZRouter可以在四个模块间相互跳转,从而达到模块解耦效果。模块关系图如下图: ohos zrouter 1 1、在EntryAbility的onCreate()方法中初始化ZRouter,建议使用initialize()方法进行初始化,init()方法已弃用 onCreate(want: Want, launchParam: AbilityConstant.LaunchParam): void { // 如果项目中存在hsp模块则传入true ZRouter.initialize((config) => { config.isLoggingEnabled = BuildProfile.DEBUG config.isHSPModuleDependent = true }) } 建议在AbilityStage的onCreate()方法中完成初始化 export class AppAbilityStage extends AbilityStage{ onCreate(): void { // 应用HAP首次加载时触发,可以在此执行该Module的初始化操作(例如资源预加载、线程创建等)。 // 在module.json5配置文件中,通过配置 srcEntry 参数来指定模块对应的代码路径,以作为HAP加载的入口。 // 初始化路由 ZRouter.initialize((config) => { // 设置context config.context = this.context config.isLoggingEnabled = BuildProfile.DEBUG config.isHSPModuleDependent = true // 服务路由初始化配置,如果没有使用服务路由,可不设置 config.loadDynamicModule = ['@hzw/hara', 'harb', 'hspc'] config.onDynamicLoadComplete = () => { console.log("已完成所有模块的加载") } }) } }2、在Index页面使用Navigation作为根视图,通过ZRouter的getNavStack()方法获取NavPathStack实例,将其传入到Navigation的构造函数中。 如果在Index入口文件中启动Splash页面,建议放在Navigation的onAppear方法中进行启动,或者组件的onPageShow方法,具体可参考demo // Index 中使用 aboutToAppear 生命周期函数会因为 Navigation 还没初始化完成导致无法有效跳转,可使用替换成 onPageShow @Entry @Component struct Index { build() { // 获取NavPathStack实例对象 Navigation(ZRouter.getNavStack()){ Column({space:12}){ Button('toHarAMainPage').onClick((event: ClickEvent) => { // 跳转页面 ZRouter.push("harAMainPage") }) } } .title('Main') .height('100%') .width('100%') .onAppear(() => { // 启动Splash页面 ZRouter.push("SplashPage") }) } }通过ZRouter的pushXX()方法进行页面跳转,参数是@Route装饰器上的name属性值;或者用ZRouter的getNavStack()方法来执行页面跳转。 3、在NavDestination子页的使用自定义@Route或@ZRoute注解标注页面,其中name属性是必填的,页面跳转需要用到name值,还有另外三个可选属性分别是: description:页面描述,没有功能作用; needLogin:如果页面需要登录,可以将值设置为true,然后在拦截器中做页面重定向到登录页; extra:额外的值可以通过该属性设置 @Route/@Service/@ZAttribute/@ZLifecycle等自定义注解上的name属性支持使用静态常量,在后面文档有详细介绍代码如下: @Route({ name: 'hspCPage1', needLogin:true ,extra: 'hsp'}) @Component export struct Page1 { @State message: string = 'Hello World'; build() { NavDestination(){ Column({space:12}){ Button('toHarAPage1').onClick((event: ClickEvent) => { ZRouter.push("harAPage1") }) } } .title('hspCPage1') .width('100%') .height('100%') } } 如果觉得每个页面都要用NavDestination组件包裹太麻烦,可以使用NavDestination模板化功能。建议通过ZRouter.getInstance()方式来操作路由的跳转与关闭,使用会更灵活简洁,之前的ZRouter的静态方法依然保留着,在1.2.0版本起将标记为过期状态了。 ZRouter.getInstance() .setParam("root data") .setLunchMode(LaunchMode.STANDARD) // 启动模式 .setAnimate(true) .setPopListener((r) => { LogUtil.log("index result: ", r.data ," from: ", r.from); }) .navigation("harAPage3")全局拦截器 全局拦截器每个页面跳转都会触发,可以拦截器中做页面跳转的拦截,比如跳转前拦截、数据预取、登录拦截,404拦截、埋点、自定义URL路径等等。 代码示例: export class GlobalNavigateInterceptor implements IGlobalNavigateInterceptor{ static count = 0 onNavigateBefore: (destInfo: DestinationInfo) => Promise = (destInfo) => { console.log("IInterceptor Global onNavigateBefore -> ", destInfo.name) return new Promise((resolve, _) => { if (destInfo.name === RouterConstants.PAGE_BEFORE_PUSH) { // 拦截跳转到ParamPage页面 if (GlobalNavigateInterceptor.count === 0) { destInfo.param = ' 在拦截器onNavigateBefore中已替换参数 ' destInfo.next() // 继续跳转 默认的 ,可以不写 } else if (GlobalNavigateInterceptor.count === 1) { ToastUtils.show("拦截器onNavigateBefore中已拦截, 再点一次会继续执行") destInfo.block() // 拦截跳转 } else if (GlobalNavigateInterceptor.count === 2) { destInfo.name = RouterConstants.LIFECYCLE_CASE_VIEW } GlobalNavigateInterceptor.count += 1 } resolve(destInfo) }) } onRootWillShow: ((fromContext: NavDestinationContext) => void) | undefined = (fromContext) => { console.log("IInterceptor Global onRootWillShow: ", fromContext.pathInfo.name) } onPageWillShow: ((fromContext: NavDestinationContext, toContext: NavDestinationContext) => void) | undefined = (from ,to)=>{ console.log("IInterceptor Global onPageWillShow: ", from, to.pathInfo.name, to.pathInfo.param) } onNavigate: ((context: InterceptorInfo) => void) | undefined = (info)=>{ if (info.notRegistered) return console.log("IInterceptor Global onNavigate -> ", info.name) let isLogin = AppStorage.get("isLogin") if (info.isNeedLogin && !isLogin) { let param = info.param ZRouter.getInstance() .setParam(param) .setAnimate(true) .setPopListener((result) => { if (result.data) { // 登录成功 promptAction.showToast({ message: `登录成功` }) return true // 返回true 则继续跳转登录前的页面 } else { return false } }) .redirect("LoginPage", RedirectType.REPLACE) } } } // 添加拦截器 ZRouter.setGlobalInterceptor(new GlobalNavigateInterceptor()) 当页面未注册时,可以通过以下方式处理: 跳转到404页面:使用 redirect() 方法直接重定向到404页面 跳转到登录页面:使用 redirect() 方法跳转到登录页,并可以设置回调函数处理登录结果 登录setPopListener的回调函数工作流程: 登录成功时,回调函数返回 true,继续跳转到原来的目标页面 登录失败或取消时,回调函数返回 false,停止跳转 登录页面代码示例: @Route({ name: 'LoginPage'}) @Component export struct LoginPage{ build() { NavDestination(){ Column({space:15}){ Button('登录成功').onClick((event: ClickEvent) => { // 模拟登录 AppStorage.setOrCreate('isLogin', true) ZRouter.finishWithResult(true) }) } .width('100%') .height('100%') } .width('100%') .height('100%') .title('LoginPage') } }在登录成功后通过ZRouter.finishWithResult()方法携带数据关闭页面,内部会将状态传递给redirectForResult2()方法中的回调函数,最终在setPopListener中接收处理。 NavDestination页面模板化 在介绍基本使用的流程中,我们知道每个页面都需要通过NavDestination来包裹,这样会造成代码的冗余,因此可通过ZRouter的模板化能力将NavDestination层去除。 具体使用见详细文档 自定义URL路径跳转 在项目中一般会设计一套统一的URL路径跳转规范,通过URL路径跳转到不同原生页面。比如下面的URL路径: hzw://hello?id=69&name=harAPage3获取URL路径上的name参数进行跳转原生页面,可以设置一个拦截器来拦截URL路径跳转。代码示例: 跳转: Button('https://www.baidu.com?id=66&name=hspCIndex').onClick((event: ClickEvent) => { ZRouter.getInstance() .navigation("https://www.baidu.com?id=66&name=hspCIndex") }) Button('hzw://hello?id=69&name=harAPage3').onClick((event: ClickEvent) => { ZRouter.getInstance() .navigation("hzw://hello?id=69&name=harAPage3") })拦截器: export class UrlInterceptor implements IInterceptor { // 设置拦截器优先级,数值越大则优先执行 priority: number = 10000; process: (context: InterceptorInfo) => InterceptorInfoOrNull = (context) => { console.log("IInterceptor process: ", this.priority , context.name) // 自定义URL路径是没有注册的 if (context.notRegistered) { // 如果是URL路径跳转 if (this.isLink(context.name)) { // 拦截到URL路径跳转,进行处理 const map = this.parseQueryString(context.name) const name = map.get('name') if (name) { // 跳转原生页面 ZRouter.getInstance() .setParam(map.get("id")) .navigation(name) } } else { ZRouter.getInstance().redirect("PageNotFound2") } return null // 返回null则拦截掉 } return context }; isLink(str: string): boolean { const linkRegex = /^(hzw:\/\/|http:\/\/|https:\/\/|www\.).+/; return linkRegex.test(str); } parseQueryString(queryString: string) { let params = new HashMap(); let queryStringWithoutQuestionMark = queryString.split('?')[1]; if (queryStringWithoutQuestionMark) { let keyValues = queryStringWithoutQuestionMark.split('&'); keyValues.forEach((keyValue) => { let pair = keyValue.split('='); let key = decodeURIComponent(pair[0]); let value = decodeURIComponent(pair[1]); params.set(key, value) }) } return params; } }上面的逻辑也可以放在全局拦截器的onNavigateBefore()方法中处理。 注解上使用静态常量,可跨模块定义 router-register-plugin插件1.0.7版本起,@Route与@Service注解的name属性可使用静态常量,方便统一管理路由名称;静态常量支持当前模块或跨模块定义,常量的定义模版如下: export class RouterConstants { public static readonly URL_TEST_PAGE: string = "url_test"; public static readonly HARA_MAIN_PAGE :string = "harAMainPage" }如果路由常量在一个公共模块定义,建议在模块的Index.ets文件导出,另外RouterConstants的文件必须是.ets后缀,不支持ts后缀文件。具体可参考案例服务路由-模块间通信 服务路由主要用于实现模块之间的通信,模块间是相互独立且不直接依赖于彼此。 1.0.9版本开始支持,具体使用可见详情文档 或者参考demo生命周期函数管理 ZRouter的组件生命周期管理能力,主要有两个特点: 不影响你原有的生命周期业务逻辑,对NavDestination页面保持着零侵入性,整合了组件通用生命周期函数和NavDestination生命周期函数 可以让任何一个类具备有与组件的生命周期能力; 具体使用见详细文档 路由转场动画 从1.1.1版本起内置了转场动画(平移、旋转、渐变、缩放、高斯模糊),也支持自定义转场动画;具体使用见详细文档 第三方Navigation实例使用本库的API 如果第三方Navigation实例使用本库的API,需要将第三方Navigation的NavPathStack实例注册到ZRouter中,代码示例: aboutToAppear(): void { // 在合适的时机注册导航栈 // let s = ZRouter.getNavStackByName(NAV_STACK_NAME) ZRouter.registerNavStack(NAV_STACK_NAME, this.stack) } aboutToDisappear(): void { ZRouter.unregisterNavStack(NAV_STACK_NAME) } 上面是模拟代码,具体注册的时机需要根据实际情况来定。NAV_STACK_NAME是一个自定义常量,用于标识导航栈的名称。 页面跳转: Column({ space: 15 }) { Text(this.msg) Button("harAMainPage").onClick((event: ClickEvent) => { ZRouter.getInstance(NAV_STACK_NAME) .setAnimate(true) .setPopListener((v) => { this.msg = v.data?.toString() + ' ' + v.from?.toString() }) .navigation("harAMainPage") }) }把标识导航栈的名称NAV_STACK_NAME,入参到ZRouter.getInstance()方法中,就可使用ZRouter的API。 在ArkUI-X项目上的使用 router-register插件在ArkUI-X项目的配置有所不同,需要使用者自己手动修改下hvigorfile.ts文件,详细见ArkuiX-ZRouter,或者issues IB35F5 混淆 生产环境需要在每个模块的obfuscation-rules.txt文件添加混淆配置: -keep-file-name Index _generated ZR*工作原理 路由注册流程代码是由插件在编译阶段自动化生成,其原理是不难的,通过Hvigor插件扫描指定目录的ets文件,递归解析ets文件的语法树节点,查找解析注解上的参数,然后将这些信息通过模板引擎生成对应的代码逻辑。 与Java注解处理器原理是类似的ZRouter库是对NavPathStack对进行高度封装的,包括了页面跳转、自定义拦截器、服务路由、生命周期回调、转场动画、NavDestination模板化等功能,提供了更简洁易用的API,其中部分思想参考了Android ARouter路由框架。 编译插件的基本流程图: WX20250805 103406 接口列表 查看详细文档 FQA 查看详细文档 源码 gitee:https://gitee.com/common-apps/ZRouter github:https://github.com/751496032/ZRouter 参与贡献 Fork 本仓库 新建分支 提交代码 新建 Pull Request 待优化项 服务路由:支持在entry模块动态注册; 拦截器: onNavigateBefore()兼容系统push 等api拦截; onNavigateBefore()支持获取注解中的参数; 页面模板化:在模板化下支持页面路由组件直接参数携带,非模板功能已支持了; * ...(内容过长,已截断,更多详情请访问项目地址) ⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/common-apps/ZRouter/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
Taro {card-default label="? 项目信息"} ? 项目名称:Taro ? 开发语言:JavaScript ⭐ Star数:1129 | ? Fork数:219 ? 开源协议:MIT ? 项目地址:https://gitee.com/o2team/Taro {/card-default} 项目介绍 开放式跨端跨框架解决方案,支持使用 React/Vue/Nerv 等框架来开发微信/京东/百度/支付宝/字节跳动/ QQ 小程序/H5/React Native/鸿蒙 等应用。 https://taro.zone/ 项目详情 Taro 开放式跨端跨框架解决方案,轻松构建可以运行在 小程序/Web/APP 上的应用 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 项目截图 简体中文 | English ? Taro['tɑ:roʊ],泰罗·奥特曼,宇宙警备队总教官,实力最强的奥特曼。目录 简介 学习资源 社区共享 项目状态 使用案例 加入共建 问题反馈与建议 特别鸣谢 贡献者们 开发计划 更新日志 开发交流 简介 开放式跨端跨框架解决方案,支持使用 React/Vue/Nerv 等框架来开发微信/京东/百度/支付宝/字节跳动/ QQ 小程序/H5/React Native 等应用。现如今市面上端的形态多种多样,Web、React Native、微信小程序等各种端大行其道,当业务要求同时在不同的端都要求有所表现的时候,针对不同的端去编写多套代码的成本显然非常高,这时候只编写一套代码就能够适配到多端的能力就显得极为需要 版本迁移 Taro 1/2 迁移至 Taro 3,请阅读《Taro 版本升级权威指南》 学习资源 5 分钟上手 Taro 开发 awesome-taro 社区共享 Taro 物料市场——让每一个轮子产生价值 UI 库 名称地址介绍支持的框架支持的 Taro 版本taro-uihttps://taro-ui.jd.com/#/一套基于 Taro 框架开发的多端 UI 组件库ReactTaro 1/2/3NutUIhttps://nutui.jd.com/#/京东风格的轻量级移动端 Vue 组件库Vue3Taro 3taroifyhttps://taroify.github.io/taroify.com/introduce/轻量、可靠的小程序端 Taro 组件库(Vant 的 Taro 版本)ReactTaro 3@antmjs/vantuihttps://antmjs.github.io/vantui/#/home基于有赞 VantWeapp 开发的同时支持 Taro 和 React 的 UI 库ReactTaro 3Tardhttps://tard-ui.selling.cn/一套基于 Taro 框架开发的多端 React UI 组件库ReactTaro 3duxuihttps://duxapp.cn/docs/duxui/start/一套能同时兼容小程序、React Native、鸿蒙、H5的移动端ui组件库ReactTaro 4项目状态 title= 使用案例 Taro 已经投入了我们的生产环境中使用,业界也在广泛地使用 Taro 开发多端应用。 项目截图 征集更多优秀案例 加入共建 加入 Taro 社区共建倡议 Taro 邀你加入社区共建 为 Taro 贡献代码 Taro 非常欢迎社区开发者为 Taro 贡献代码,在贡献之前请先阅读贡献指南。 如果你想为 Taro 实现一个重要功能,需要先撰写 RFC 文档,按照 Taro 的RFC 机制进行操作,在经过社区讨论完善后才可以进行代码的提交。 问题反馈与建议 给 Taro 提 ISSUE 强烈推荐阅读 《提问的智慧》、《如何向开源社区提问题》 和 《如何有效地报告 Bug》、《如何向开源项目提交无法解答的问题》,更好的问题更容易获得帮助。Let's fund issues in this repository 特别鸣谢 nanjingboyjsNewbeeQiyu8Garfield550nanjingboyjsNewbeeQiyu8Garfield Lee贡献者们 项目截图 开发计划 Milestones 更新日志 本项目遵从 Angular Style Commit Message Conventions,更新日志请查阅 Release。 开发交流 官方交流微信群 License MIT License Copyright (c) O2Team Permission is hereby granted, free of charge, to any person obtaining a copy of this software and associated documentation files (the "Software"), to deal in the Software without restriction, including without limitation the rights to use, copy, modify, merge, publish, distribute, sublicense, and/or sell copies of the Software, and to permit persons to whom the Software is furnished to do so, subject to the following conditions: The above copyright notice and this permission notice shall be included in all copies or substantial portions of the Software. THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY, FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM, OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OR OTHER DEALINGS IN THE SOFTWARE. ⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/o2team/Taro/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
Dora-SSR {card-default label="? 项目信息"} ? 项目名称:Dora-SSR ? 开发语言:C++ ⭐ Star数:233 | ? Fork数:43 ? 开源协议:MIT ? 项目地址:https://gitee.com/ippclub/Dora-SSR {/card-default} 项目介绍 Dora SSR 是一款跨平台的游戏引擎,提供前沿或是具有探索性的游戏开发功能。它内置了Web IDE,提供了可以轻轻松松通过浏览器访问的快捷游戏开发环境,特别适合于在新兴市场如国产游戏掌机和其它移动电子设备上直接进行游戏开发和编程学习。 项目详情 多萝珍奇引擎(Dora SSR) Web IDE · Coding Agent 真机开发游戏引擎 English | 中文 Release Discord QQ群 Ask DeepWiki OpenAtom Dora SSR 是一款跨平台游戏引擎,直接运行在游戏的目标设备上——手机、掌机或桌面电脑。通过同一网络内任意浏览器打开内置的 Web IDE,即可针对真实运行时编写、检查与迭代代码,而不是脱离设备的预览;引擎还内置了 AI 编程智能体。支持原生运行于 Android、iOS、Windows、macOS、Linux 与 鸿蒙。 浏览器中的 Web IDE,实时编辑运行在设备上的代码。 为什么选择 Dora SSR 针对真实运行时开发。 引擎运行在目标设备上,浏览器只是一扇窗。所改即所运行——没有模拟器、没有导出步骤、也没有脱离设备的预览。 浏览器里的完整工具链。 Web IDE 提供项目文件、类型化编辑、补全、诊断与定义跳转,并内置动画、粒子、物理、剧本、Git 等常用编辑器。 内置 AI 编程智能体。 编程智能体 将 LLM 辅助开发带入 Web IDE——支持项目技能、持久记忆、API 查询、安全编辑、构建检查、运行时验证与子智能体派发。 引擎在设备上,开发随时随地。 内置编程智能体 你可以让它分析项目、查询 API、安全地修改代码并验证运行结果。智能体在引擎内部工作,具备持久记忆、项目技能与子智能体派发能力。 内置编辑器 常见的游戏制作任务都在 Web IDE 内完成: 动画编辑器 —— 骨骼动画时间线 粒子编辑器 —— 实时预览特效 物理编辑器 —— 编辑碰撞体 Yarn 编辑器 —— 剧本与节点图 可视化脚本编辑器 —— 用节点搭建逻辑 Spine 预览 —— 检查骨骼动画数据 Git 客户端 —— 提交历史与变更 性能分析器 —— 运行时调试与剖析 此外还内置:TIC-80 编辑器、瓦片地图支持、Excel 到数据库的工作流,以及 Scratch 风格的 Blockly 可视化编程。 运行时能力 场景与 3D —— 树形 2D / 3D 场景、易用的 ECS 模块、相机、材质、光照、模型、动画与 3D 物理。 2D 制作 —— Spine2D、DragonBones、内置骨骼动画、PlayRho 物理、瓦片地图、粒子与复古 TIC-80 内容。 图形与媒体 —— 异步资源加载、Ogg/Theora 视频、多格式空间音效、运行时 shader 编译、Effekseer、NanoVG、ImGui 与 TrueType 字体渲染。 UI 与叙事 —— CSS Flex 布局、响应式 TSX 界面与 Yarn Spinner 故事系统。 数据 —— 异步访问 SQLite,并提供 Excel 到数据库的工作流。 游戏模式 —— 2D 平台游戏的可复用逻辑与 AI 框架,以及机器学习玩法框架。 开发语言 用团队熟悉的语言编写游戏代码——它们调用的是同一套引擎 API: Lua TypeScript TSX Teal YueScript Wa Rust C# 更习惯积木块而不是代码?Blockly 提供 Scratch 风格的可视化编程,适合教学与原型开发。 TSX 尝鲜——使用 React 风格 API 声明式地搭建场景,由 TSTL 编译: import { React, toNode } from 'DoraX'; import { Ease } from 'Dora'; toNode( )?.slot("Count", (_, param) => print(param));TSX 代码与其渲染出的响应式界面,实时运行在原生运行时中。 全部支持语言的 Hello World Lua local _ENV = Dora local sprite = Sprite("Image/logo.png") sprite:once(function() for i = 3, 1, -1 do print(i) sleep(1) end print("Hello World") sprite:perform(Sequence( Scale(0.1, 1, 0.5), Scale(0.5, 0.5, 1, Ease.OutBack) )) end)Teal local sleep = require("sleep") local Ease = require("Ease") local Scale = require("Scale") local Sequence = require("Sequence") local Sprite = require("Sprite") local sprite = Sprite("Image/logo.png") if not sprite is nil then sprite:once(function() for i = 3, 1, -1 do print(i) sleep(1) end print("Hello World") sprite:perform(Sequence( Scale(0.1, 1, 0.5), Scale(0.5, 0.5, 1, Ease.OutBack) )) end) endYueScript —— 有关 Dora SSR 所支持的这门小众语言的故事在这里。 _ENV = Dora with Sprite "Image/logo.png" \once -> for i = 3, 1, -1 print i sleep 1 print "Hello World!" \perform Sequence( Scale 0.1, 1, 0.5 Scale 0.5, 0.5, 1, Ease.OutBack )TypeScript import { Sprite, Ease, Scale, Sequence, sleep } from 'Dora'; const sprite = Sprite("Image/logo.png"); if (sprite) { sprite.once(() => { for (let i of $range(3, 1, -1)) { print(i); sleep(1); } print("Hello World"); sprite.perform(Sequence( Scale(0.1, 1, 0.5), Scale(0.5, 0.5, 1, Ease.OutBack) )) }); }TSX 响应式风格 —— toNode() 适合一次性的静态场景构建;需要根据数据变化更新 TSX 树时,可以使用 createRoot() 配合 signal() 进行 diff 渲染。新手教程参见这里。 import { React, createRoot, signal } from 'DoraX'; import { Director } from 'Dora'; const count = signal(0); const root = createRoot(Director.entry); root.render(() => ( Count: {count.value} )); count.value += 1;Wa —— 作为脚本语言运行在 Dora SSR 内置的 WASM 运行时上,并获得热重载的开发体验。 import "dora" func init { sprite := dora.NewSpriteWithFile("Image/logo.png") sprite.RunActionDef( dora.ActionDefSequence(&[]dora.ActionDef{ dora.ActionDefEvent("Count", "3"), dora.ActionDefDelay(1), dora.ActionDefEvent("Count", "2"), dora.ActionDefDelay(1), dora.ActionDefEvent("Count", "1"), dora.ActionDefDelay(1), dora.ActionDefScale(0.1, 1, 0.5, dora.EaseLinear), dora.ActionDefScale(0.5, 0.5, 1, dora.EaseOutBack), }), false, ) sprite.Slot("Count", func(stack: dora.CallStack) { stack.Pop() param, _ := stack.PopStr() dora.Println(param) }) }Rust —— 编写 Rust 代码并构建为名为 init.wasm 的 WASM 文件,上传到引擎中加载运行。详情见这里。 use dora_ssr::*; fn main () { let mut sprite = match Sprite::with_file("Image/logo.png") { Some(sprite) => sprite, None => return, }; let mut sprite_clone = sprite.clone(); sprite.schedule(once(move |mut co| async move { for i in (1..=3).rev() { p!("{}", i); sleep!(co, 1.0); } p!("Hello World"); sprite_clone.perform_def(ActionDef::sequence(&vec![ ActionDef::scale(0.1, 1.0, 0.5, EaseType::Linear), ActionDef::scale(0.5, 0.5, 1.0, EaseType::OutBack), ])); })); }使用 Dora SSR 制作的游戏 Loli War Zombie Escape Dismantlism Luv Sense Digital 参考 Dora-Example 了解各项 API 与引擎能力的最小用法。 参考 Dora-Demo 了解完整项目如何组织资源、脚本与游戏逻辑。 安装 Android 在目标设备上下载并安装 APK。 启动软件,它会显示一个地址,供同一网络内其他设备的浏览器访问。 在浏览器中打开该地址,即可进入 Web IDE。 Windows [!IMPORTANT] 请先安装 Visual Studio 2022 的 X86 Visual C++ 可再发行组件包。下载并解压软件,启动后通过浏览器访问显示的地址。 macOS 下载并解压软件,或通过 Homebrew 安装: brew install --cask ippclub/tap/dora-ssr启动软件,并通过浏览器访问显示的地址。 Linux Ubuntu Jammy sudo add-apt-repository ppa:ippclub/dora-ssr sudo apt update sudo apt install dora-ssrDebian Bookworm sudo apt-key adv --keyserver hkp://keyserver.ubuntu.com:80 --recv-keys 9C7705BF sudo add-apt-repository -S "deb https://ppa.launchpadcontent.net/ippclub/dora-ssr/ubuntu jammy main" sudo apt update sudo apt install dora-ssr启动软件,并通过浏览器访问显示的地址。 编译构建引擎 详见官方文档。 Android iOS Windows Linux macOS 从安装到第一个游戏 在 Web IDE 左侧的 工作空间 上打开右键菜单,新建一个文件夹作为项目。 在项目下新建入口文件,命名为 init,可选 Lua、YueScript、Teal、TypeScript 或 TSX(见「开发语言」)。 按下 Ctrl + R,或点击编辑器右下角 ? 图标并选择 运行,游戏即在设备上运行。 右键项目文件夹并选择 下载,导出打包后的项目文件。 [!TIP] 快速上手教程有更详细的图文说明。文档与社区 学习 —— 快速上手 · API 参考 · DeepWiki 问答 社区 —— Discord · QQ 群 512620381 示例 —— Dora-Example · Dora-Demo Dora SSR 由 I++ 俱乐部开发维护,欢迎加入我们! 参与贡献 欢迎参与 Dora SSR 的开发和维护!提交 Issue 和 Pull Request 前,请先阅读贡献指南。 开放原子开源基金会 Dora SSR 现为开放原子开源基金会的捐赠与孵化期项目。我们将继续致力于建设一个更开放、更协作的游戏开发环境。 许可证 Dora SSR 使用 MIT 许可证。 [!NOTE] 请注意,Dora SSR 集成了 Spine 运行时库,这是一个商业软件。在你的项目中使用 Spine 运行时需要获取 Esoteric Software 提供的有效商业许可证。有关获取许可证的更多详细信息,请访问 Spine 官方网站。 请确保遵守所有许可要求,再在项目中使用 Spine 运行时。或者可以使用同样集成的开源 DragonBones 系统作为动画系统的替代方案。如果你只需要创建比较简单的动画,也可以使用 Dora SSR 提供的 Model 动画模块看是否能满足需要。⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/ippclub/Dora-SSR/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
Tenon {card-default label="? 项目信息"} ? 项目名称:Tenon ? 开发语言:C ⭐ Star数:119 | ? Fork数:33 ? 开源协议:Apache-2.0 ? 项目地址:https://gitee.com/tenonos/tenon {/card-default} 项目介绍 基于libos架构的操作系统核心库及构建工具 项目详情 Static Version Badge Static License Badge Static Language Badge TenonOS:简化复杂性,释放创新力,重塑操作系统的开发模式 TenonOS是一款基于LibOS架构的操作系统,旨在提升操作系统扩展、裁剪、移植效率,基于丰富的微库组件池,实现跨场景、跨行业、跨领域的快速能力复用,灵活生成与场景最契合的OS实体。 架构 与传统宏内核、微内核架构的操作系统不同,Tenon采用微库解耦架构,借鉴Unikraft的实现方式,将kernel、驱动、服务进一步拆分封装成接口解耦、功能独立的微库,使用Kconfig进行微库配置和依赖关系管理。Tenon不约束操作系统或内核必须由哪些部件组成,用户可以根据自己的需求选择TenonOS社区或UK社区提供的微库,甚至可以基于框架提供的API封装实现自己的调度器、内存分配器、线程池、同步锁、特定系统调用等微库,达到任意裁剪、新增、优化操作系统功能的目的,使软硬件性能、资源利用率达到极致。 目前Tenon的构建代码和基础框架使用Unikraft V0.16.0版本作为基线,并增加以下平台和主要特性: 支持的平台 平台CPU架构启动协议状态树莓派arm64Linux 64-bit boot protocol已支持rk3568arm64Linux 64-bit boot protocol已支持kvmarm64Linux 64-bit boot protocol已支持d9arm64Linux 64-bit boot protocol已支持关键特性 [x] 支持嵌入式平台:plat-raspi、plat-rk3568 [x] posix接口兼容 -- 持续更新 [x] 调试工具:openocd+gdb [x] 调试工具:NS8250串口驱动 [x] 实时微库:支持抢占式调度 [x] 实时微库:支持中断抢占、中断嵌套 [x] 同步微库:支持自旋锁、互斥锁、信号量、消息队列 [x] 支持虚拟文件系统 [x] 网络微库:netdev框架 [ ] SMP:支持多核启动和跨核调度 [ ] 网络微库:rk3568网卡驱动 示例应用 helloworld rtos-benchmark 对象识别 busybox 如何使用 代码结构 除Tenon框架API和核心微库外,TenonOS社区主仓还提供了用于编译构建的板级支持包仓库、以app为前缀的应用仓库、以lib为前缀的外部微库、以driver为前缀的外部驱动微库、以plat为前缀的外部平台仓库。这些微库会在后续逐步开源。构建时工作目录结构如下 . ├── apps /*此目录用于维护运行在os之上的app,下为示例*/ │ ├── app-busybox │ ├── app-elfloader │ ├── app-helloworld │ ├── app-helloworld-cpp │ └── app-tflite ├── board-support-package /*此目录用于维护板级支持包,包括设备树、bootloader等。下为示例*/ │ ├── kvm │ └── raspberry-pi-3b+ ├── drivers /*此目录用于维护外部驱动,“外部”指不在tenon核心仓维护的代码仓*/ ├── libs /*此目录用于维护外部微库,下为示例*/ │ ├── lib-libcxx │ └── lib-tflite-micro ├── plats /*此目录用于维护外部平台,包含对应平台的os初始化代码。下为示例*/ │ ├── plat-raspi │ └── plat-rk3568 └── tenon /*tenon核心仓库,用于维护API框架和内部微库*/ ├── arch /*cpu架构相关代码*/ ├── build /*保存构建出的镜像和中间产物*/ ├── drivers /*用于维护内部驱动*/ ├── include /*跨微库共用的宏定义、结构体定义等*/ ├── lib /*用于维护框架微库和内部微库*/ ├── plat /*用于维护内部平台,如kvm*/ └── support /*编译构建脚本*/使用指导 Tenon使用make完成编译构建,当前支持kvm、树莓派3b+、rk3568等平台,使用指导请参考quick_start 社区贡献 Tenon欢迎各方以个人、组织、企业形式参与到社区贡献当中,贡献指导请参考Contributing License Tenon采用Apache-2.0开源许可协议。当前代码仓中仍有部分unikraft代码,unikraft采用BSD-3-Clause开源许可协议。当前开发过程中,若要修改uk原有微库的代码,请保留文件中原有LICENSE说明,新增微库或特性请使用Apache-2.0协议。后续开源进程中我们将逐步移除对uk代码的依赖。 参考资源 设计文档 API文档 博客 RequestForComments 微库中心 社区主页 Roadmap ⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/tenonos/tenon/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
天翼云盘快速下载解析源码 源码介绍 因为虽然天翼云盘下载不限速,但是每次下载都需要登录比较麻烦,于是做了这个东西。HTML单页,直接上传就能用! 源码截图 1.png ⬇️ 下载地址 {cloud type="weiyun" title="腾讯微云" url="https://share.weiyun.com/npF3nupe"} {cloud type="tianyi" title="天翼云盘" url="https://cloud.189.cn/t/Jn6nue3QVNfy"} {cloud type="default" title="网盘下载" url="https://www.yun.cn/s/8492836adc6d42ccb4b324243f66ee4b"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
MVSO影视自动采集源码 源码介绍 MVSO影视程序,精简UI,魔改超强SEO,程序对接360影视,和可以自己自定义苹果cms资源站接口,程序后端采用layuimini进行实现。 源码截图 1.jpg 2.png 使用说明 上传直接访问使用,无需安装 请用php7.1|7.2(推荐PHP7.2) 宝塔伪静态用thinkphp,EP面板上传直接用 不支持二级目录搭建本程序 nginx伪静态在根目录.nginx.htaccess apache在根目录.htaccess ep面板无需设置伪静态 后台地址:域名/admin/index 用户名:mvso 密码 :123456 资源站接口是苹果CMS XML接口,部分接口不支持 ⬇️ 下载地址 {cloud type="weiyun" title="腾讯微云" url="https://share.weiyun.com/31GJvqKX"} {cloud type="tianyi" title="天翼云盘" url="https://cloud.189.cn/t/nABjMzRnmAzm"} {cloud type="default" title="网盘下载" url="https://www.yun.cn/s/baa7b30520824f52b18634a9f8340cb5"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
在线浏览美图源码+py源码 源码介绍 美图网站千千万,美图自己说了算!本源码由@香谢枫林 开发,首页图片做了浏览器窗口自适应,最大化占满PC浏览器和移动浏览器的窗口,并且防止出现滚动条。 源码截图 1.png 2.png 功能介绍 首页图片设置了4个点击功能区,分别是:上一张、下一张、全部随机、套图集随机(为了丰富移动端操作) 搜索功能注释隐藏了,想用的同学自己打开发开者模式解除注释即可 随机按钮:仅在右上角下拉菜单选中的图集中随机 随机All按钮:全部图片中随机 自动随机:仅在右上角下拉菜单选中的图集中自动随机(间隔1.5s) 自动随机All:全部图片中自动随机(间隔1.5s) 自动浏览:自动下一张(间隔1.5s) 套图1:点击跳转新窗口,查看套图所有图片(观赏模式一) 套图2:点击跳转新窗口,查看套图所有图片(观赏模式二) 索引:点击跳转新窗口,查看套图集 收藏:收藏图片,点击”Count“也能收藏 收藏列表:点击跳转新窗口,观赏收藏图片 注:键盘任意键或者点击图片即可解除自动浏览状态; 按键介绍 @上一张:<--(左方向键) @下一张:-->(右方向键) @全部图集随机:(上方向键 或 alt键) @所选图集随机:(下方向键 或 shift键) @跳转套图第一张:(空格键) @收藏:(?问号键) @浏览整套图片(模式1):({左大括号) @浏览整套图片(模式2):(}右大括号) @关闭标签页(针对跳转的页面):(\顿号) @自动浏览(随机全部图集1.5s间隔):(”冒号键) @自动浏览(随机所选图集1.5s间隔):(;分号键) @回看随机历史:(《左书名号键) @自动浏览(下一张1.5s间隔):(》右书名号键) 注:任意键结束自动浏览状态;"{}"这两个按键在套图浏览页面可以切换浏览模式 使用说明 第一步:本地建库,把数据库下载到本地(线上数据库连接参数在global.php文件里)也可以自己创建数据库,需要3个基础表,分别是pc_dic_lanvshen、pc_dic_toxic、po_toxic(在数据库文件夹下) 第二步:修改数据库配置,global.php文件的database配置,设置成连接自己本地的数据库;到此,启动网站,你可以愉快的赏图了! 1.想改按键怎么办?在js/index.js文件中,有具体的按键对应功能说明,想改按键,只需要修改对应的键值即可(keyCode键值问度娘吧) 2.搜过功能有木有?在index.php文件中,取消注释id为tb和tj的两行代码即可显示搜索功能 爬虫说明 我做了3个美图网站的数据爬取功能,分别对应3个文件:lanvshen.py,lanvshen_qtw.py,lanvshen_mtll.py(顶部有注释对应哪个网站) 第一步:修改数据库配置文件conf/mysql_db.py,修改数据库连接,改成自己本地的数据库; 第二步:找到自己想要爬取的页面,修改主函数信息即可,只需要修改4个参数,如下图所示 3.png 注:Python记得下载好对应的插件(requests,re,time,random,BeautifulSoup) ⬇️ 下载地址 {cloud type="weiyun" title="腾讯微云" url="https://share.weiyun.com/rP7Nkl7F"} {cloud type="tianyi" title="天翼云盘" url="https://cloud.189.cn/t/rMjiauUjqYbm"} {cloud type="default" title="网盘下载" url="https://www.yun.cn/s/407bd0cb513c439f9e1c18d6e80886b6"} 下载后请先检查文件完整性,如有问题请在评论区反馈
-
抖音14部影片免费看 附片单 1月28日消息,继《囧妈》后,西瓜视频、抖音、今日头条已于昨日20点起独家免费播出影片《疯狂的外星人》。该片为2019年春节贺岁档影片,由宁浩执导,黄渤、沈腾主演,此前仅可在欢喜首映客户端付费观看。这是《疯狂的外星人》首次在第三方视频平台播出。 20200128114702_2772.jpg 与此同时,《唐人街探案》、《港囧》、《夏洛特烦恼》等12部影片也一并上线,与《囧妈》、《疯狂的外星人》共同组成「线上免费春节档」。用户可通过西瓜视频、抖音或今日头条任一App或智能电视“鲜时光”免费观看相关影片。 附「线上免费春节档」14部片单: 《囧妈》 《疯狂的外星人》 《唐人街探案》 《夏洛特烦恼》 《捉妖记2》 《美人鱼》 《羞羞的铁拳》 《人在囧途》 《港囧》 《澳门风云3》 《缝纫机乐队》 《欢乐喜剧人》 《心花路放》 《西游伏妖篇》 下载后请先检查文件完整性,如有问题请在评论区反馈
-
清粥茶画会2024手绘水彩课 2.png 课程介绍 《清粥茶画会2024手绘水彩课》课程专为水彩爱好者设计,聚焦茶文化与清粥主题的手绘创作。课程涵盖水彩基础技法、色彩搭配、构图技巧等,帮助学员在轻松愉悦的氛围中提升绘画能力,创作出富有文化韵味的水彩作品,享受艺术的乐趣。 学习地址 百度:https://pan.baidu.com/s/1B1u0htl3UJZfSR2cqiPylw?pwd=a3vr 天翼:https://cloud.189.cn/t/v2qQraYvaABb(访问码:npu8) 阿里:https://www.alipan.com/s/egZg3JqbVV6 夸克:https://pan.quark.cn/s/d8ffb6af1d33 下载后请先检查文件完整性,如有问题请在评论区反馈