找到 779 篇与 6666 相关的结果 - 第 35 页
-
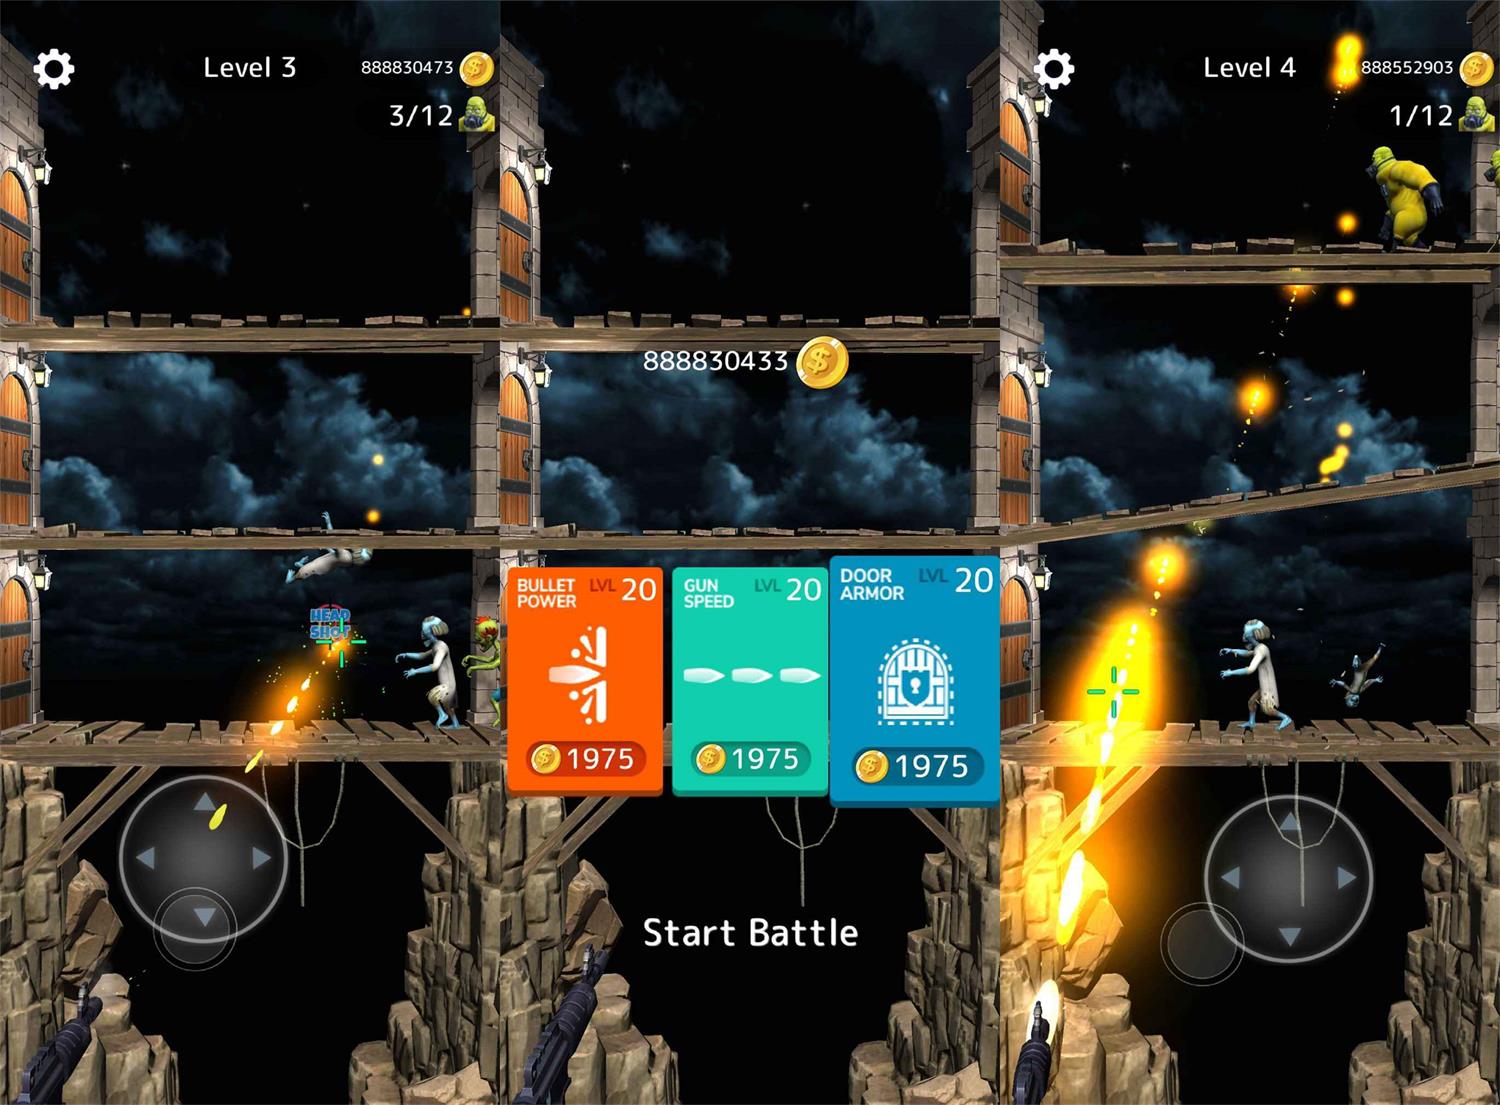
《烟花 202X》v10991214中文版 游戏介绍 2000年登陆主机的动作益智游戏大作《奇幻幻视》强势回归! 烟花在屏幕上爆炸的闪闪发光的图像和简单而深刻的游戏玩法一旦你掌握了它。 这种独一无二的体验极大地增强了沉浸在烟花中的沉浸式和令人上瘾的体验。 游戏 游戏《烟花 202X》v10991214中文版 图片4 《烟花 202X》v10991214中文版 图片6 《烟花 202X》v10991214中文版 图片8 《烟花 202X》v10991214中文版 图片10 《烟花 202X》v10991214中文版 图片12 《烟花 202X》v10991214中文版 图片14 版本介绍 Build.10991214|容量2.34GB|官方简体中文|支持键盘.鼠标.手柄 ⬇️ 下载地址 {cloud type="tianyi" title="天翼云盘" url="https://cloud.189.cn/web/share?code=v6ruQb7fQFzu%20%EF%BC%88%E8%AE%BF%E9%97%AE%E7%A0%81%EF%BC%9Aj95t%EF%BC%89"} 下载后请先检查文件完整性,如有问题请在评论区反馈 -
广东三网免费领取流量秒到 广东三网免费领取流量秒到 图片1 3月24日置顶新一期:限广东号码参加 广东移动领10元话费 下载咪咕APP->首页顶部轮播图->新用户瓜分百万或点抽话费->进去抽奖 活动地址:https://tb3.cn/AAyXHg 广东移动领5元话费 1、下载和彩云APP->首页中间轮播图找到->赢百元话费->进来后立即备份->然后返回首页 2、点左上角->手机备份->再点“自动备份”->然后去我的->领奖专区领取->手动兑换即可 活动地址:https://tb3.cn/ArLNM9 广东移动领7元话费 微信小程序搜“和彩云网盘”->首页顶部->新春话费限时领”->进去上传文件+创建群组邀请个好友互点 活动地址:https://tb3.cn/AZKWzS 广东电信每天领1G流量 活动地址:https://tb3.cn/ABSwMf 全国联通每天领1G流量 活动地址:https://tb3.cn/AQNuOw 下载后请先检查文件完整性,如有问题请在评论区反馈 -
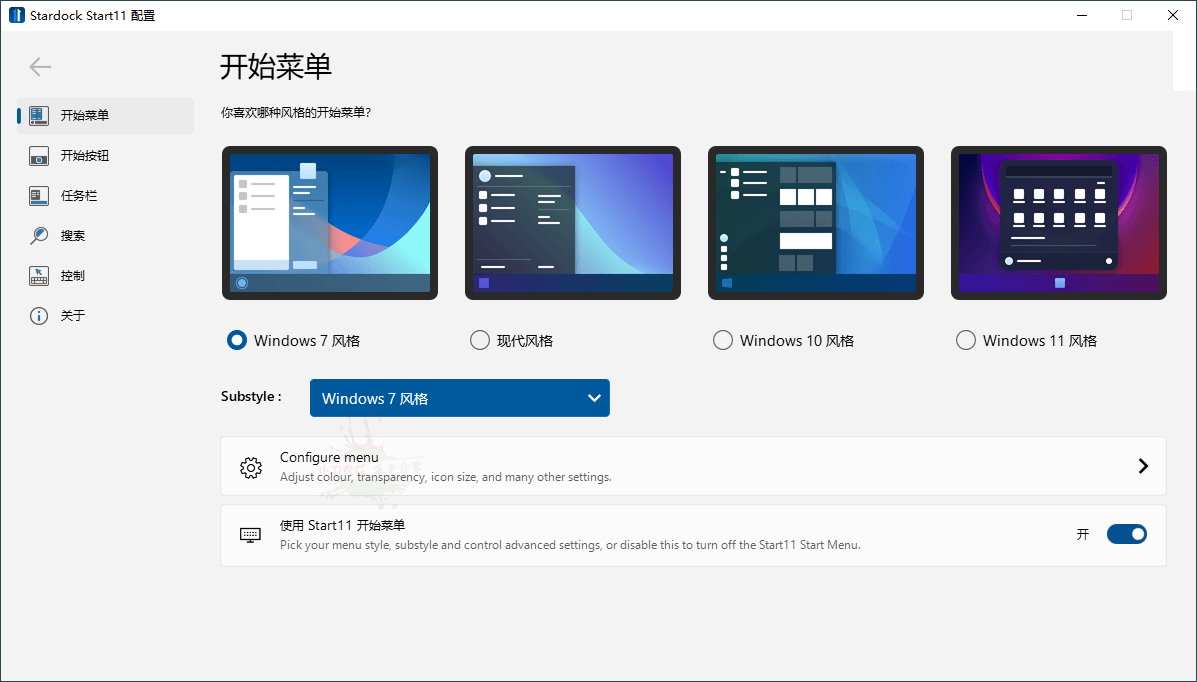
开始菜单Stardock Start11 v2.80 软件介绍 Stardock Start11,Windows11开始菜单增强工具,Start8/Start10/Start11系列产品是一款Win8/Win10/Win11开始菜单恢复工具,在任务栏上添加开始按钮,为Windows 8、Windows 10、Windows 11恢复经典功能Win7样式开始菜单风格,自定义功能包括:开始菜单、任务栏、按钮样式,菜单操作的配置优化等。 软件开始菜单Stardock Start11 v2.80 图片2开始菜单Stardock Start11 v2.80 图片4 更新日志 https://www.stardock.com/products/start11/history 2026.09.04 v2.8.0.2 Final 适配Win11 26H2新版任务栏,默认遵循系统自身设置 「由Windows控制任务栏位置」开启时,位置设置才生效 系统限制各显示器统一设置,可自行调整任务栏尺寸,多屏不同位置请用Start11选项 修复副屏垂直任务栏显示异常问题 修复垂直任务栏下Edge图标空白等显示bug 修复未开启增强任务栏时开始按钮失灵问题 修复增强任务栏上部分应用图标错乱 全部关闭任务栏功能后,自定义右键菜单同步停用 整体性能优化,ARM处理器提升尤为明显 版本特点 by DIAKOV 反汇编处理,脱离许可证密钥依赖,直装免激活! 添加了Modern主题样式,删除了升级程序和服务 保留了英文/俄语/中文语言,修改后重新打包而成 ⬇️ 下载地址 下载后请先检查文件完整性,如有问题请在评论区反馈 -
OpenNJet {card-default label="? 项目信息" /} ? 项目名称:OpenNJet ? 开发语言:C ⭐ Star数:1372 | ? Fork数:62 ? 开源协议:MulanPSL-2.0 ? 项目地址:https://gitee.com/njet-rd/njet {/card-default} 项目介绍 OpenNJet 实现了NGINX 云原生功能增强、安全加固和代码重构,利用动态加载机制可以实现不同的产品形态,如Web服务器、流媒体服务器、负载均衡、代理(Proxy)、应用中间件、API网关、消息队列等产品形态等等。 项目详情 OpenNJet OpenNJet 应用引擎是高性能、轻量级的WEB应用与代理程序。作为云原生服务网格的数据平面,NJet具备动态配置加载、主动式健康检测、集群高可用、声明式API等多种强大功能。通过CoPliot副驾驶服务框架,在隔离控制面和数据面的情况下实现了高可扩展性。NJet应用引擎助力企业实现云原生技术的平滑升级并大幅降低IT运营成本。 项目![OpenNJet 图片1 OpenNJet 是由开放原子开源基金会(OpenAtom Foundation)孵化及运营的开源项目! 项目![OpenNJet 图片3 独特优势 ✨高性能:NJet性能是CNCF推荐Envoy的三倍。 ✨功能多:内置HTTP3、故障注入、遥测、配置动态加载、服务发现等功能 ✨强安全:集成Web应用防火墙、原生支撑国密/ RSA加密解密算法 ✨可扩展:强大的插件框架能力支撑第三方应用开发 ✨可编程:支持LUA、Python可编程控制脚本 ✨易管理:提供完善的API接口,内置多主集群和高可用性能力 更多功能特性 -> 查看 技术架构 项目![OpenNJet 图片5 路线图 功能规划 迅速开始 我们提供了几种迅速利用的方法: 二进制安装 发行版安装 源码安装 docker镜像启动 镜像构建 如果大家想制作OpenNJet镜像,可使用如下方法: 下载njet_main源码,执行如下命令: cd njet_main #导入环境变量 export NJET_REPOSITORY="tmlake/njet" export NJET_TAG="latest" #构建镜像 docker build --build-arg NJet_VERSION=$NJET_TAG --build-arg GIT_COMMIT=$(git rev-parse HEAD) --network host --target ubuntu-njet -f ./build/docker/Dockerfile_njet -t $NJET_REPOSITORY:$NJET_TAG ./更多详情查看 社区文档 获取更多的信息和使用说明,可以从 文档 开启OpenNJet的世界! 快速上手 编码规范&新手指引 使用手册 开发指南 参与贡献 如果您对我们的项目十分感兴趣,请查看 贡献指南 了解更多贡献的流程,当然,我们也十分欢迎您通过Issue的方式帮助修正我们的贡献流程。 社区交流 技术交流面对面:探讨和分享对 NJet 的建议、使用心得、发展方向等 QQ群号:607280080 项目![OpenNJet 图片7 安全说明 如果您在使用过程中发现任何安全问题,请通过以下方式直接联系我们: 邮箱:lijhaal@tmlake.com 许可证 OpenNJet 基于 MulanPSL-2.0 许可证! ⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/njet-rd/njet/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈 最后提醒一下,资源仅供学习交流使用,请于下载后24小时内删除。 -
OnnxOCR {card-default label="? 项目信息" /} ? 项目名称:OnnxOCR ? 开发语言:Python ⭐ Star数:164 | ? Fork数:43 ? 开源协议:Apache-2.0 ? 项目地址:https://gitee.com/jingsongliujing/OnnxOCR {/card-default} 项目介绍 基于PaddleOCR重构,并且脱离PaddlePaddle深度学习训练框架的轻量级OCR,推理速度超快 —— A lightweight OCR system based on PaddleOCR, decoupled from the PaddlePaddle deep learning training framework, with ultra-fast inference speed. 项目详情 OnnxOCR 如果项目对您有帮助,欢迎点击右上角 Star 支撑! onnx_logo 基于 ONNXRuntime 的高性能多语种 OCR 工程 GitHub stars GitHub forks GitHub license Python Version AtomGit Star English | 简体中文 | 日本語 版本更新 2026.05.27 新增 OCR + Qwen3.5-2B ONNX 信息抽取使用方法。 新增 onnxocr.qwen35_2b 包内模块,用于 Qwen3.5-2B ONNX 模型下载、校验和纯 Python 推理。 新增 examples/id_card_extract_with_qwen.py 端到端示例:先用 OnnxOCR 做全量文字识别,再用 Qwen3.5-2B 抽取身份证结构化字段。 Qwen3.5-2B ONNX 使用独立 ModelScope 仓库:supersong/qwen2bonnx。 2026.05.01 新增 ONNX 车牌检测与车牌号识别能力。 新增基于 RapidTable 的 ONNX 表格识别能力。 新增基于 RapidLayout 的中英文版面分析能力。 新增基于 RapidDoc 的文档版面分析与 Markdown 导出能力。 ONNXPaddleOcr 新增 use_plate_recognition、use_table_recognition、use_layout_analysis 参数,默认均为 False,原有通用 OCR 调用方式不受影响。 新增 /plate、/table、/layout、/layout_markdown 等 HTTP 接口。 2025.05.21 新增 PP-OCRv5 模型,单模型支撑简体中文、繁体中文、中文拼音、英文、日文。 整体识别精度相比 PP-OCRv4 提升。 识别效果与 PaddleOCR 3.0 保持一致。 核心优势 脱离深度学习训练框架:可直接用于部署的通用 OCR 工程。 跨架构支持:基于 PaddleOCR 转换的 ONNX 模型,可部署在 ARM 和 x86 架构设备上。 统一推理引擎:项目内 ONNX 模型统一通过 onnxocr/inference_engine.py 创建 ONNXRuntime Session。 多语种支持:单模型支持 5 种文字类型。 国产化适配友好:下游厂商适配 GPU/NPU 时,优先修改统一推理引擎即可。 环境安装 python>=3.8 pip install -i https://pypi.tuna.tsinghua.edu.cn/simple -r requirements.txt说明: 仓库默认只包含 tests/test_general_ocr.py 所需的 PP-OCRv5 通用 OCR 模型。 车牌识别、表格识别、版面分析、方向分类、RapidDoc Markdown 导出等扩展模型较大,国内优先从 ModelScope 下载,也可以使用 HuggingFace 或国内镜像站 https://hf-mirror.com。 PP-OCRv5 Server ONNX 模型也可下载后替换 onnxocr/models/ppocrv5/ 下的 det/rec 模型。 模型下载 扩展模型统一托管在 ModelScope 和 HuggingFace。国内网络建议优先使用 ModelScope models 目录: python scripts/download_models.py等价的 ModelScope 核心代码如下: from modelscope import snapshot_download model_dir = snapshot_download("supersong/onnxocr_model")如果希望从 HuggingFace 下载,可使用: python scripts/download_models.py --source huggingfaceHuggingFace 模型地址:jingsongliu/onnxocr_model。 国内访问 HuggingFace 较慢时,可使用镜像站 hf-mirror.com: python scripts/download_models.py --source huggingface --hf-endpoint https://hf-mirror.com脚本会把模型仓库中的 models/ 目录同步到本地 onnxocr/models/,并检查 RapidDoc 所需的 onnxocr/models/rapid_doc/layout/pp_doclayoutv2.onnx 等关键文件是否存在。 只检查本地模型是否齐全: python scripts/download_models.py --check-onlyQwen3.5-2B 信息抽取基座 OnnxOCR 也可以在 OCR 之后接入本地 Qwen3.5-2B ONNX 模型,作为信息抽取基座使用。典型流程是: 先用 OnnxOCR 对图片做全量文字识别,得到文本和文本框。 再把 OCR 文本交给 Qwen3.5-2B ONNX,抽取为结构化 JSON。 OCR 和抽取都在本地通过 Python + ONNXRuntime 运行,不依赖 JS。 Qwen3.5-2B ONNX 使用独立模型仓库,和车牌、表格、版面分析等可选 OCR 模型不是同一个下载地址: ModelScope:supersong/qwen2bonnx 本地目录:onnxocr/models/qwen_2b 准备 Qwen3.5-2B ONNX 模型: python examples/qwen35_2b_onnx.py download --variant q4 python examples/qwen35_2b_onnx.py verify模型默认放在: onnxocr/models/qwen_2b纯 Python 文本/图文推理冒烟测试: python examples/qwen35_2b_onnx.py run-python --prompt "你好,简易介绍一下你自己。" python examples/qwen35_2b_onnx.py run-python --onnxocr/models/qwen_2b/s/demo.jpeg --prompt "用一句话描述这张图片。"也可以直接调用包内 API: from onnxocr.qwen35_2b import Qwen35ONNX qwen = Qwen35ONNX("onnxocr/models/qwen_2b") text, stopped = qwen.generate("从下面 OCR 文本中抽取字段:...") print(text)扩展新的场景抽取模板: from onnxocr.qwen35_2b import ExtractionTemplate, QwenScenarioExtractor invoice_template = ExtractionTemplate( name="invoice_basic", description="发票 OCR", fields=["发票号码", "销售方", "购买方", "价税合计", "开票日期"], rules=[ "只根据 OCR 文本抽取,不要编造。", "缺失或不确定的字段填空字符串。", "只输出 JSON,不要解释。", ], ) extractor = QwenScenarioExtractor(model_dir="onnxocr/models/qwen_2b") fields, raw = extractor.extract(ocr_text, template=invoice_template) print(fields)基础包不内置任何垂直场景提示词。请把场景模板放在你的应用代码或 examples/ 中,再传给 QwenScenarioExtractor。你可以通过定义字段和规则,继续扩展发票、营业执照、合同、快递面单、医疗报告、质检单等垂直 OCR 场景。 一键运行通用 OCR python test_ocr.pytest_ocr.py 默认只运行通用 OCR。车牌识别、表格识别、版面分析、RapidDoc Markdown 导出示例已在文件中注释,下载对应模型后按需取消注释即可。 独立测试文件: python tests/test_general_ocr.py python tests/test_license_plate_ocr.py python tests/test_table_ocr.py python tests/test_layout_analysis.py python tests/test_layout_markdown.py测试输出默认写入 result_/,该目录已加入 .gitignore。 通用 OCR import cv2 from onnxocr.onnx_paddleocr import ONNXPaddleOcr = cv2.imread("onnxocr/test_s/715873facf064583b44ef28295126fa7.jpg") model = ONNXPaddleOcr(use_angle_cls=False, use_gpu=False) result = model.ocr() print(result)OCR + Qwen 信息抽取 examples/id_card_extract_with_qwen.py 是一个最小端到端垂直场景示例。可复用的 Qwen 推理和通用模板抽取代码位于 onnxocr.qwen35_2b,身份证字段和提示词规则只放在该示例脚本中。 默认示例: python examples/id_card_extract_with_qwen.py指定图片路径: python examples/id_card_extract_with_qwen.py --"onnxocr/test_s/8f113149-ff64-4c9f-8dc0-e34100365aa4.jpg"输出文件: result_/id_card_front_qwen_extract.json脚本默认不会在控制台打印身份证敏感字段,只会写入本地 JSON。仅在可信本地环境中使用 --show-sensitive 查看抽取明细。 车牌识别 车牌识别作为可选模式融合到 ONNXPaddleOcr 中,默认仍使用原来的通用 OCR 流程。 from onnxocr.onnx_paddleocr import ONNXPaddleOcr, sav2Plateplate_model = ONNXPaddleOcr( use_angle_cls=True, use_gpu=False, use_plate_recognition=True, plate_min_score=0.4, ) plate_result = plate_model.ocr() sav2Plate模型文件: onnxocr/models/license_plate/car_plate_detect.onnx onnxocr/models/license_plate/plate_rec.onnx表格识别 表格识别集成自 RapidTable,复用通用 OCR 的文字检测和识别结果,再进行表格结构还原,输出 HTML、单元格框和逻辑行列坐标。 from onnxocr.onnx_paddleocr import ONNXPaddleOcr, sav2Tabletable_model = ONNXPaddleOcr( use_angle_cls=True, use_gpu=False, use_table_recognition=True, table_model_type="slanet_plus", ) table_result = table_model.ocr() print(table_result["html"]) sav2Table模型文件: onnxocr/models/table/slanet-plus.onnx onnxocr/models/table/ch_ppstructure_mobile_v2_SLANet.onnx onnxocr/models/table/en_ppstructure_mobile_v2_SLANet.onnx中英文版面分析 版面分析集成自 RapidLayout,用于定位文档图像中的标题、正文、表格、图片、页眉页脚等元素。 from onnxocr.onnx_paddleocr import ONNXPaddleOcr, sav2Layoutlayout_model = ONNXPaddleOcr( use_gpu=False, use_layout_analysis=True, layout_model_type="pp_layout_cdla", ) layout_result = layout_model.ocr() sav2Layout英文版面模型可将 layout_model_type 设置为 pp_layout_publaynet。 模型文件: onnxocr/models/layout/layout_cdla.onnx onnxocr/models/layout/layout_publaynet.onnx文档转 Markdown 文档转 Markdown 集成自 RapidDoc,支持根据版面分析结果识别标题、段落、表格和图片等内容,并保存为 Markdown 文件。 from onnxocr.layout_markdown import LayoutMarkdownConverter converter = LayoutMarkdownConverter( layout_model_type="pp_doclayoutv2", formula_enable=False, table_enable=True, ) result = converter.convert_file( "onnxocr/test_s/layout_cdla.jpg", output_md_path="./result_/test_layout_markdown.md", ) print(result["markdown_path"])RapidDoc 模型文件: onnxocr/models/rapid_doc/layout/pp_doclayoutv2.onnx onnxocr/models/rapid_doc/table/q_cls.onnx onnxocr/models/rapid_doc/table/unet.onnx onnxocr/models/rapid_doc/table/slanet-plus.onnx推理引擎适配 项目中的通用 OCR、车牌识别、表格识别、版面分析和 RapidDoc 文档解析都通过 onnxocr/inference_engine.py 创建 ONNXRuntime Session。 如果需要适配下游厂商 GPU/NPU,通常只需要修改: from onnxocr.inference_engine import create_session核心扩展点: create_session(model_path, providers=None, use_gpu=False, gpu_id=0, sess_options=None) build_providers(use_gpu=False, gpu_id=0, providers=None) build_providers_from_engine_cfg(engine_cfg) ProviderConfig(engine_cfg) 当前项目只有 onnxocr/inference_engine.py 直接 import onnxruntime,业务模块不直接依赖 ONNXRuntime API。 API 服务 app-service.py 是用于部署的 JSON API 服务,webui.py 是浏览器可视化服务。两者分离后,项目更容易部署、测试和维护。 启动 API 服务: python app-service.py环境变量: ONNXOCR_PORT:服务端口,默认 5005。 ONNXOCR_USE_GPU:设为 1 / true 时启用 GPU provider。 ONNXOCR_DEBUG:设为 1 / true 时启用 Flask debug。 ONNXOCR_OUTPUT_DIR:Markdown 和资源输出目录,默认 result_。 ONNXOCR_MAX_UPLOAD_MB:最大上传大小,单位 MB,默认 200。 主要接口支持 JSON base64 图片,也支持 multipart 文件上传: /health:服务健康检查。 /ocr:通用 OCR。 /plate:车牌识别。 /table:表格识别。 /layout:版面分析。 /layout_markdown:图片或 PDF 转 Markdown。 JSON 示例: curl -X POST http://127.0.0.1:5005/ocr \ -H "Content-Type: application/json" \ -d "{\"\":\"\"}"multipart 示例: curl -X POST http://127.0.0.1:5005/ocr \ -F "=@onnxocr/test_s/715873facf064583b44ef28295126fa7.jpg"启动 WebUI: python webui.pyDocker 镜像环境 docker build -t ocr-service . docker run -itd --name onnxocr-service -p 5006:5005 ocr-serviceDocker 构建通过 .dockerignore 排除缓存、运行输出和可选大模型文件。车牌、表格、版面分析、RapidDoc 等扩展模型可以在镜像内按需下载,也可以运行时挂载。 代码结构 app-service.py # 可部署 JSON API 服务 webui.py # 浏览器可视化服务 test_ocr.py # 本地一键 OCR 示例 requirements.txt # 运行依赖 Dockerfile # API 服务容器镜像 .dockerignore # 排除缓存、输出和大模型文件 Readme.md # 英文文档 Readme_cn.md # 中文文档 Readme_ja.md # 日文文档 onnxocr/ inference_engine.py # 唯一 ONNXRuntime 入口 onnx_paddleocr.py # 用户统一调用入口 predict_det.py # 通用 OCR 检测 predict_rec.py # 通用 OCR 识别 orientation.py # 本地 RapidOrientation ONNX 适配 license_plate.py # 车牌识别 table_recognition.py # 表格识别封装 layout_recognition.py # 版面分析封装 layout_markdown.py # RapidDoc Markdown 导出封装 rapid_layout/ # RapidLayout 源码级 ONNX 集成 rapid_table/ # RapidTable 源码级 ONNX 集成 rapid_doc/ # RapidDoc 源码级 ONNX 集成 models/ # 本地 ONNX 模型 scripts/ download_models.py # 可选模型下载/检查脚本 tests/ # 独立功能测试和 API 烟测效果展示 示例 1示例 2!!示例 3示例 4!!联系与交流 OnnxOCR 交流群 微信群 QQ群 致谢 非常感谢 PaddleOCR 提供的技术支持和模型参考。 非常感谢 RapidAI 开源社区,以及其中 RapidTable、RapidLayout、RapidDoc、RapidOrientation 等项目提供的优秀模型、代码和工程参考。 开源与捐赠 如果您认可本项目,可以通过支付宝或微信进行支持。 项目![OnnxOCR 图片42 项目![OnnxOCR 图片44 Star 历史 Star History Chart 贡献指南 欢迎提交 Issues 和 Pull Requests,共同改进项目。为了保证开源用户按文档操作时不踩坑,请遵守以下约定: API-only 能力放在 app-service.py,浏览器 WebUI 能力放在 webui.py。 不提交 result_/、results/、uploads/ 或本地缓存目录中的生成文件。 不提交客户真实单据、身份证、银行卡、医疗记录、合同、快递面单、生产密钥等敏感数据。 测试和文档样例只使用公开样例、官方示例或经过授权的脱敏样例。 如果功能依赖可选模型文件,请在 PR 中说明具体模型文件和下载命令。 README 中出现的命令必须能在当前仓库中找到对应实现,不要写未实现的入口。 提交前建议检查: python -B -m pytest tests/test_app_service.py -p no:cacheprovider python tests/test_general_ocr.py python tests/test_license_plate_ocr.py python tests/test_table_ocr.py python tests/test_layout_analysis.py python tests/test_layout_markdown.py部分测试依赖可选模型文件。如果本地无法运行,请在 PR 中说明缺少哪些模型文件。 ⬇️ 下载地址 {cloud type="default" title="网盘下载" url="https://gitee.com/jingsongliujing/OnnxOCR/repository/archive/master.zip"} 下载后请先检查文件完整性,如有问题请在评论区反馈 -
《尼尔机械纪元》v1.0中文版 游戏介绍 《尼尔:机械纪元》是由SE和白金工作室联合开发的一款动作角色扮演游戏。故事发生在和《尼尔》相同的世界,并将有一个全新的故事剧情,但和前作几乎没有关联。玩家将扮演女主角“2B”与各种各样的机器人搏斗。 游戏讲述在被摧毁的地球上由人类的敌人外星人派来的机械生命体与人类方派出的人造人“尤尔哈(YoRHa)”部队进行战斗的故事。主角叫做“尤尔哈2号B型”人造人,擅长使用刀和长剑,在战斗过程中可以随时切换。而游戏中还有被称为“POD”的机器人进行远距离支援攻击。 游戏 游戏《尼尔机械纪元》v1.0中文版 图片4 《尼尔机械纪元》v1.0中文版 图片6 《尼尔机械纪元》v1.0中文版 图片8 《尼尔机械纪元》v1.0中文版 图片10 《尼尔机械纪元》v1.0中文版 图片12 《尼尔机械纪元》v1.0中文版 图片14 版本介绍 集成1号升级档|集成修正优化补丁|容量48GB|集成v6.5完整简体中文汉化|支持键盘.鼠标.手柄|赠官方原声31首GM|赠官方原画集|赠通关存档|赠多项修改器|赠白裙MOD ⬇️ 下载地址 {cloud type="tianyi" title="天翼云盘" url="https://cloud.189.cn/t/3aiQbmUrIrmu"} 下载后请先检查文件完整性,如有问题请在评论区反馈 -
玩单机游戏遇到的那些问题 自从更新单机游戏后,很多人下载后都不看说明,直接胡乱一顿操作,导致游戏无法运行,并不找自身的原因,今天特意发一个说明说一下比较常碰到的问题! 玩单机游戏遇到的那些问题 图片1 首先是运行库问题 不安装运行库会导致游戏打开报错,丢失DLL等等,之前已经分享过点我进入,以后有需要可以直接在首页搜索“游戏运行库”或“游戏环境”关键词 玩单机游戏遇到的那些问题 图片3 3DM/游侠运行库作用:比较全的环境组件,傻瓜式解决各种文件缺失,新电脑、重装系统过后必装。 VC++合集作用:修复缺少msvcr140/120/110/100.dll问题。 DirectX修复作用:修复缺少各种DLL问题。 其次是压缩包问题 每份单机游戏下载目录中,都会带有一个WJJY.md5的文件,此文件包含压缩包的MD5信息,可验证压缩包是否完整,玩起来才没有问题,因为此前已经出现过很多因网盘下载导致压缩包损坏的问题,如果压缩包损坏还继续解压,那导致的就是游戏无法正常运行,文件缺失。 所有游戏都是分卷打包,需要全部下载完,游戏下载完后先把MD5文件拖入软件检测压缩包有无损坏,如果损坏请换个网络或等待12小时后重新下载,如压缩包验证通过,直接右键任意分卷解压出来玩耍即可。 压缩包MD5检测软件下载 下载地址1:https://xiaodao.lanzoui.com/iDVI3ilb0mh 下载地址2:https://share.weiyun.com/khFZEIhS 下载地址3:https://cloud.189.cn/t/VvIbIryMBjuu 如下图所示 玩单机游戏遇到的那些问题 图片5 最后是游戏目录问题 因为有的单机游戏它只读英文目录,如果是中文目录是读不了的。 比如 要是下到*D:\小刀* 不能玩 你要下到*D:\xiaodao* 就能玩 只要路径中包含中文,这样的游戏就运行不了,所以下载游戏切记上级目录不要带任何中文名。 另外有些游戏,系统账户名是中文也会玩不了,必须账户名为英文,比如说GTAV就是。 玩单机游戏遇到的那些问题 图片7 下载后请先检查文件完整性,如有问题请在评论区反馈 -
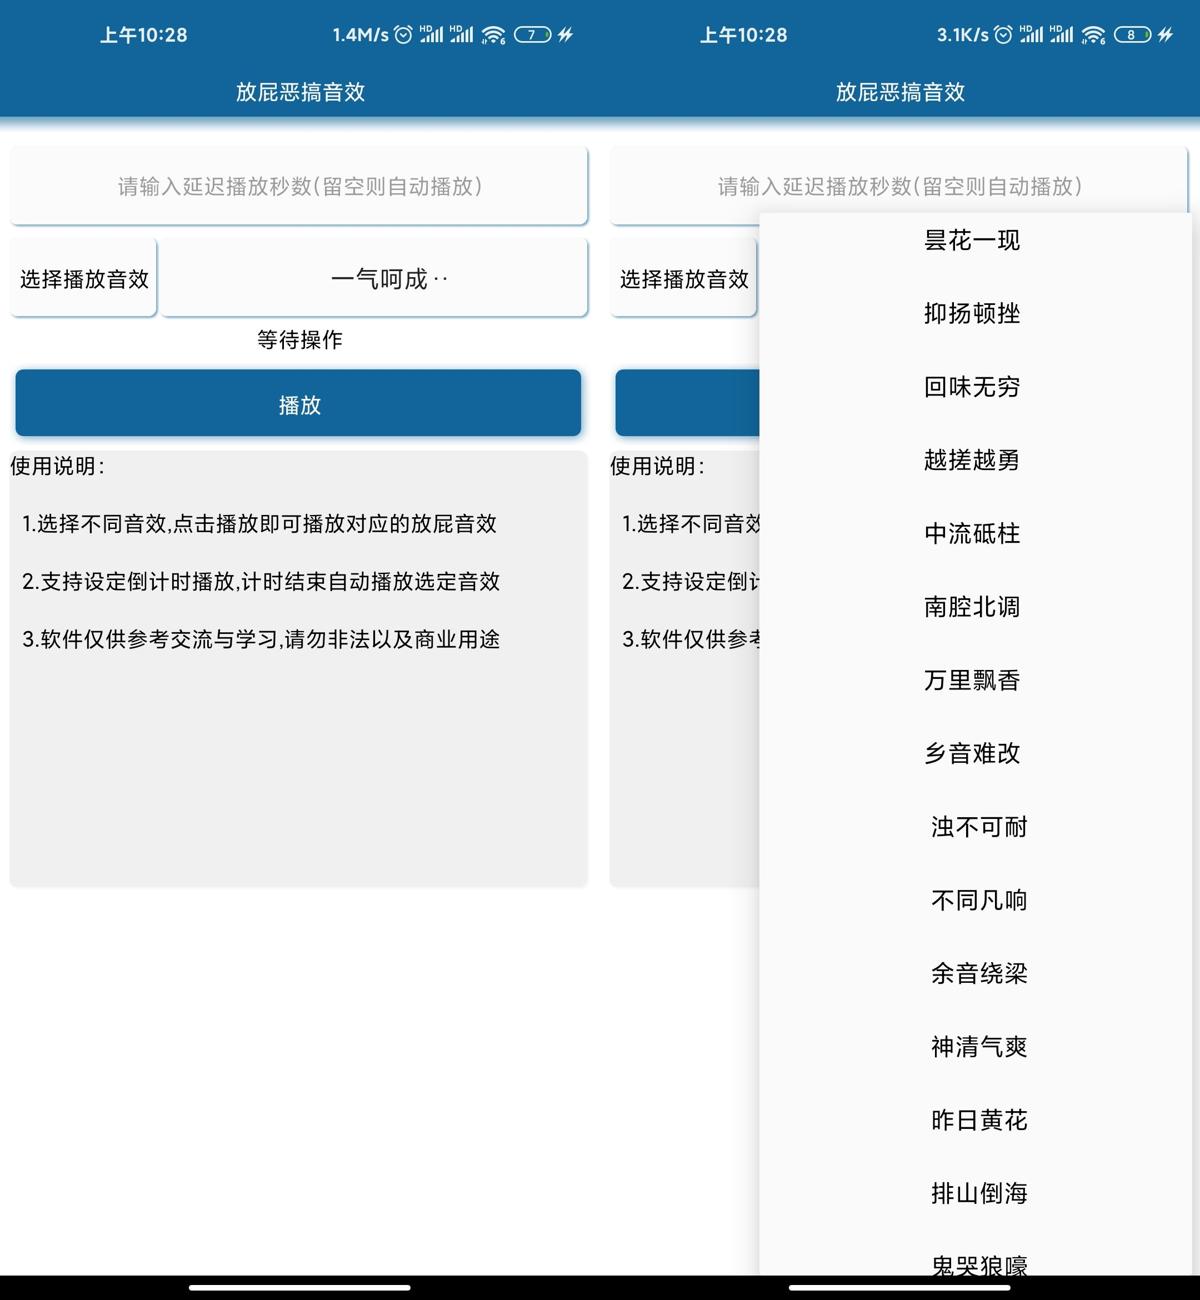
放屁音效恶搞v2.0 内置40种 软件介绍 放屁音效恶搞2.0最新版来了。软件内置40种恶搞放屁音效,超级逼真,支持延迟播放功能,学校恶搞同学、在家恶搞朋友必备神器! 软件放屁音效恶搞v2.0 内置40种 图片2 ⬇️ 下载地址 {cloud type="weiyun" title="腾讯微云" url="https://share.weiyun.com/lyCFIP72"} {cloud type="tianyi" title="天翼云盘" url="https://cloud.189.cn/t/vyQfayzyaiIn"} {cloud type="default" title="网盘下载" url="https://089u.com/file/23616629-473411582"} 下载后请先检查文件完整性,如有问题请在评论区反馈